

1. はじめに
この Codelab では、BigQuery Graph を活用して、複雑なサプライ チェーンとロジスティクスの問題を解決する方法について学びます。
食品の安全性と品質検証(QC)に焦点を当てたレストランのサプライ チェーン ネットワークをモデル化します。サプライヤーからの汚染された食材など、食品安全上の問題が発生した場合、迅速な対応が不可欠です。「影響範囲」を特定し、迅速にピンポイントでリコールを実施することで、コストを削減し、お客様を保護できます。

従来のリレーショナル モデルでは、複数のステージ(サプライヤー -> DC -> コミッサリー -> 店舗 -> 完成品)でアイテムを追跡するために、複雑なマルチステップの JOIN オペレーションが必要です。BigQuery Graph を使用すると、これらの接続を直接モデル化し、ISO GQL(Graph Query Language)標準を使用して直感的かつ高速なクエリを実行できます。
学習内容
- 既存の BigQuery テーブルの上にグラフモデルを定義する方法。
- BigQuery 内にプロパティ グラフを作成する方法。
- 走査クエリを実行して、アップストリームとダウンストリームの影響をトレースする方法。
必要なもの
- 課金が有効な Google Cloud プロジェクトが用意されていること。
- Google Cloud Shell。
費用の見積もり
このラボの BigQuery 分析料金は 5 米ドル未満と予想され、新規ユーザーの無料枠の割り当て内に収まります。
2. 設定と要件
Cloud Shell を開く
ほとんどの作業は、Cloud Shell で行います。Cloud Shell は、Google Cloud の使用に必要なものがすべて揃った、読み込み済みの環境です。
- Google Cloud コンソールに移動します。
- 右上のツールバーにある [Cloud Shell をアクティブにする] アイコンをクリックします。
- プロンプトが表示されたら、[続行] をクリックします。
環境変数を設定する
Cloud Shell で、今後のコマンドを簡素化するためにプロジェクト ID を設定します。
export PROJECT_ID=$(gcloud config get-value project)
API を有効にする
次のコマンドを実行して、必要な BigQuery API を有効にします。
gcloud services enable bigquery.googleapis.com
3. スキーマとテーブルの作成
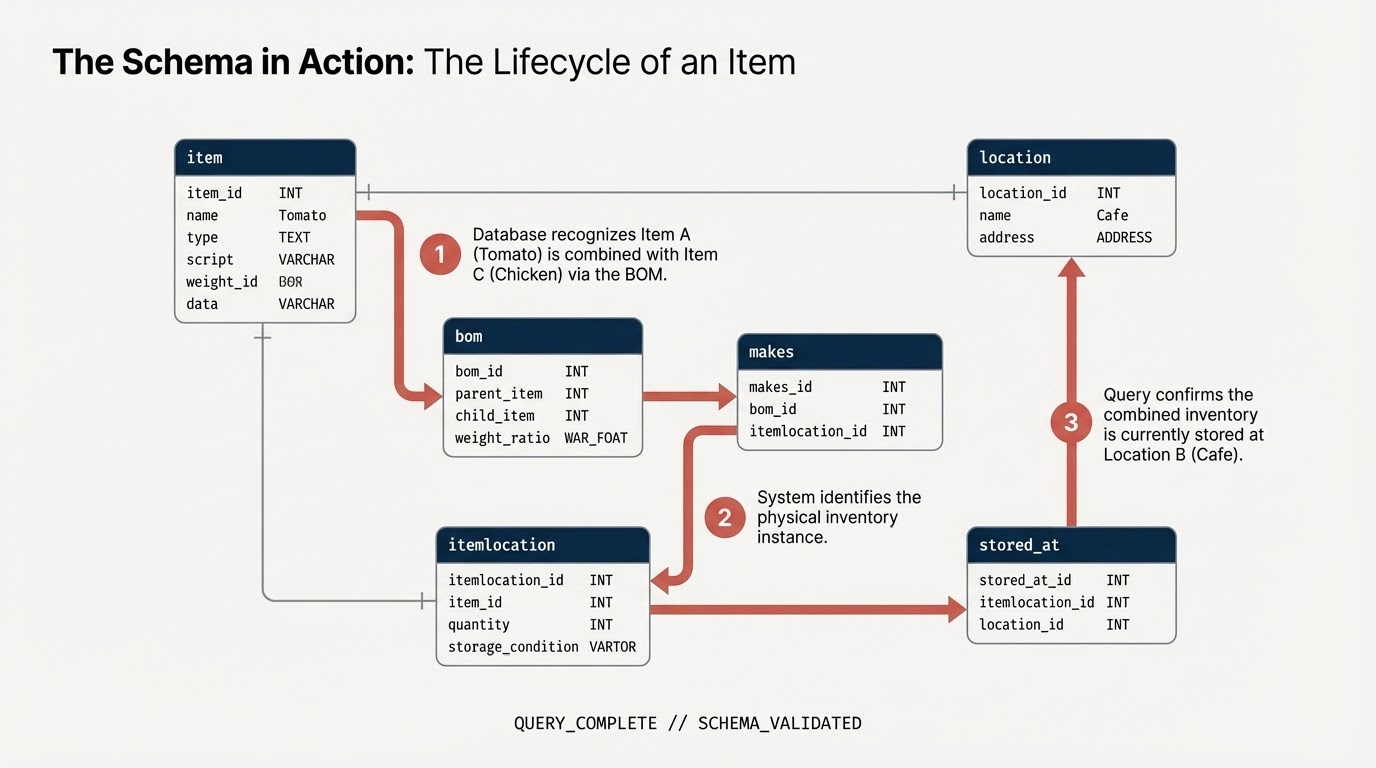
サプライ チェーンのコンポーネントを表すデータセットとテーブルを作成します。
item: 一般的なアイテムの定義(トマト、鶏肉など)。location: 施設(サプライヤー、配送センター、カフェ)。itemlocation: 在庫の場所を表す交差テーブル。bom: 部品構成表(重量関係を定義。たとえば、アイテム A がアイテム B に入るなど)。makes:itemlocationをitemにマッピングします。stored_at:itemlocationをlocationにマッピングします。
データセットの作成
このラボの SQL コマンドは、Cloud Shell または BigQuery コンソールを使用して実行できます。
BigQuery コンソールを使用するには:
- 新しいタブで BigQuery コンソールを開きます。
- このラボの各 SQL スニペットをエディタに貼り付け、[実行] ボタンをクリックして実行します。

Cloud Shell で次のコマンドを実行するか、BigQuery コンソールを使用してスキーマを作成します。SQL でノード変数を使用します。
注: (1)Google Colab でこれを実行するには、BigQuery マジック コマンド %%bigquery を使用することもできます。次のスニペットは、プロジェクト内にレストラン スキーマを作成してグラフデータを格納します。(2)Google Colab から実行する場合は、%%bigquery –project <PROJECT_ID> を使用する必要があります。PROJECT_ID フィールドが、使用する適切なプロジェクトにマッピングされていることを確認します。PROJECT_ID = "argolis-project-340214" # @param {"type":"string"}(3)Colab を使用している場合は、要件に応じていくつかのライブラリをインストールする必要があります。グラフの可視化を使用する場合は、pip を使用してライブラリ spanner-graph-notebook==1.1.5 をインストールしてください。
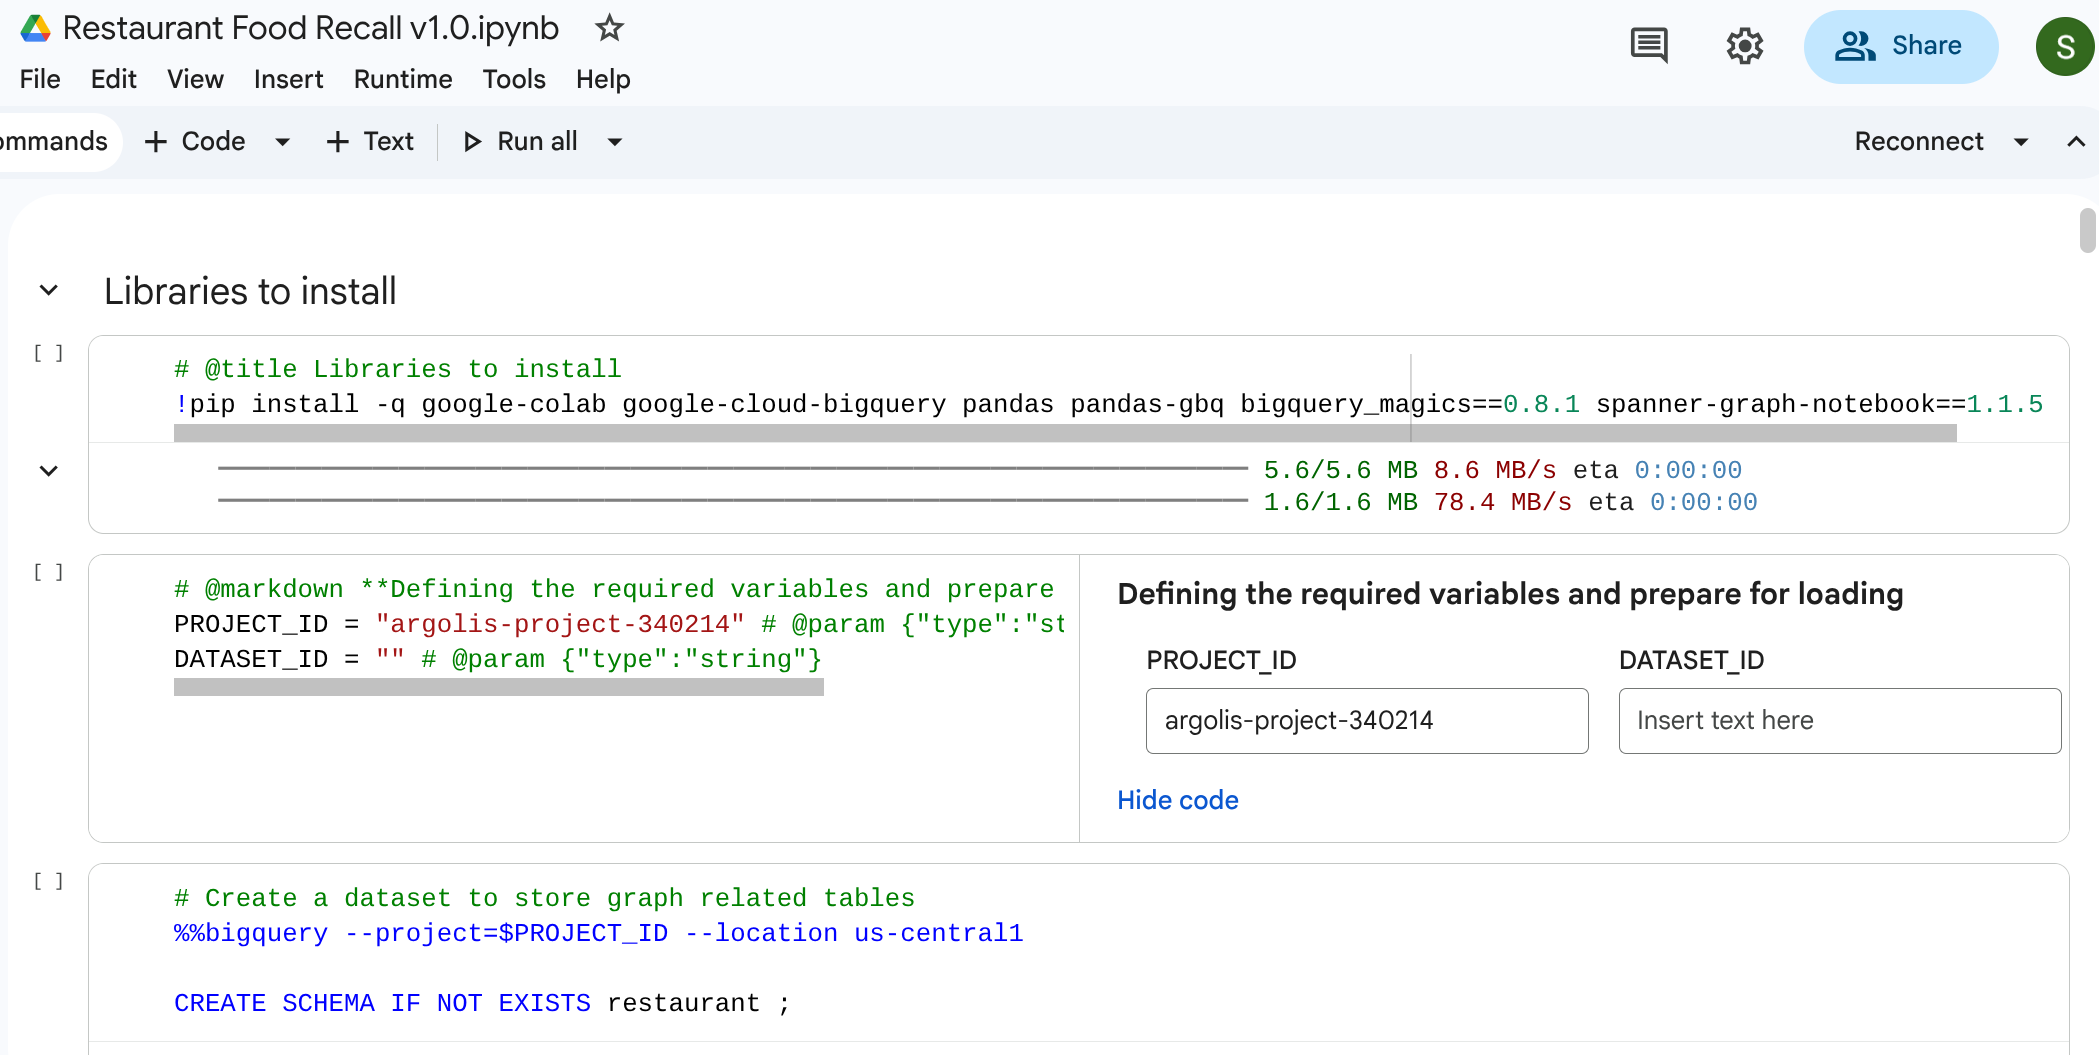
%%bigquery --project=$PROJECT_ID
CREATE SCHEMA IF NOT EXISTS restaurant ;
テーブルを作成する
次の SQL コードを実行してテーブルを作成します。
%%bigquery --project=$PROJECT_ID
-- 1. Item Table
DROP TABLE IF EXISTS `restaurant.item`;
CREATE TABLE `restaurant.item` (
  itemKey STRING,
  itemName STRING,
  itemCategory STRING,
  shelfLifeDays INT64,
  PRIMARY KEY (itemKey) NOT ENFORCED
);

-- 2. Location Table
DROP TABLE IF EXISTS `restaurant.location`;
CREATE TABLE `restaurant.location` (
  locationKey STRING,
  locationType STRING,
  locationCity STRING,
  locationState STRING,
  dunsNumber INT64,
  PRIMARY KEY (locationKey) NOT ENFORCED
);
-- 3. ItemLocation Table
DROP TABLE IF EXISTS `restaurant.itemlocation`;
CREATE TABLE `restaurant.itemlocation` (
  itemLocationKey STRING,
  itemKey STRING,
  locationKey STRING,
  variants INT64,
  PRIMARY KEY (itemLocationKey) NOT ENFORCED,
  -- Foreign Key Definitions
  FOREIGN KEY (itemKey) REFERENCES `restaurant.item`(itemKey) NOT ENFORCED,
  FOREIGN KEY (locationKey) REFERENCES `restaurant.location`(locationKey) NOT ENFORCED
);

-- 4. BOM Table
DROP TABLE IF EXISTS `restaurant.bom`;
CREATE TABLE `restaurant.bom` (
  bomKey INT64,
  parentItemLocation STRING,
  childItemLocation STRING,
  childQuantity FLOAT64,
  PRIMARY KEY (bomKey) NOT ENFORCED
);

-- 5. Makes Table
DROP TABLE IF EXISTS `restaurant.makes`;
CREATE TABLE `restaurant.makes` (
  itemLocationKey STRING,
  itemKey STRING,
  locationKey STRING,
  variants INT64,
  PRIMARY KEY (itemLocationKey) NOT ENFORCED
);

DROP TABLE IF EXISTS `restaurant.stored_at`;
CREATE TABLE `restaurant.stored_at` (
  itemLocationKey STRING,
  itemKey STRING,
  locationKey STRING,
  variants INT64,
  PRIMARY KEY (itemLocationKey) NOT ENFORCED
);
4. サンプルデータを読み込んでいます
このラボを完全に自己完結型にするため、純粋な SQL LOAD DATA ステートメントを使用してテーブルにサンプルデータを入力します。これは、サプライヤーから始まり、配送センター(DC)と共同調理場を経由して、小売カフェに到着するネットワークを表しています。
次の SQL クエリを実行してデータを読み込みます。
注: BigQuery Studio で直接実行する場合は、%%bigquery を省略できます。
%%bigquery --project=$PROJECT_ID
-- Load Item
LOAD DATA OVERWRITE `restaurant.item`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/item2.csv'], skip_leading_rows = 1);

-- Load Location
LOAD DATA OVERWRITE `restaurant.location`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/location.csv'], skip_leading_rows = 1);

-- Load ItemLocation
LOAD DATA OVERWRITE `restaurant.itemlocation`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/itemlocation.csv'], skip_leading_rows = 1);

-- Load BOM
LOAD DATA OVERWRITE `restaurant.bom`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/bom2.csv'], skip_leading_rows = 1);

-- Load Makes
LOAD DATA OVERWRITE `restaurant.makes`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/makes.csv'], skip_leading_rows = 1);

-- Load StoredAt
LOAD DATA OVERWRITE `restaurant.stored_at`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/itemlocation.csv'], skip_leading_rows = 1);
5. 制約の追加とグラフの定義
グラフを構築する前に、標準 SQL の主キー制約と外部キー制約を使用してセマンティック関係を宣言します。これらは、BigQuery がノード識別子を理解し、エッジテーブルをノードテーブルに接続するのに役立ちます。
プロパティ グラフを作成する
次に、これらのテーブルを restaurant.bombod という 1 つのまとまりのあるグラフ構造に統合します。
以下を定義します。
- Nodes:
item、location、itemlocation - エッジ:
makes、stored_at、consists_of(BOM)
%%bigquery --project=$PROJECT_ID

CREATE OR REPLACE PROPERTY GRAPH `restaurant.bombod`
NODE TABLES (
  `restaurant.item` KEY (itemKey) LABEL item PROPERTIES ALL COLUMNS,
  `restaurant.location` KEY (locationKey) LABEL location PROPERTIES ALL COLUMNS,
  `restaurant.itemlocation` KEY (itemLocationKey) LABEL itemlocation PROPERTIES ALL COLUMNS
)
EDGE TABLES (
  `restaurant.makes`
    KEY (itemLocationKey)
    SOURCE KEY (itemLocationKey) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    DESTINATION KEY (itemKey) REFERENCES `restaurant.item`(itemKey)
    LABEL makes PROPERTIES ALL COLUMNS,

  `restaurant.bom`
    KEY (bomKey)
    SOURCE KEY (childItemLocation) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    DESTINATION KEY (parentItemLocation) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    LABEL consists_of PROPERTIES ALL COLUMNS,

  `restaurant.stored_at`
    KEY (itemLocationKey)
    SOURCE KEY (itemLocationKey) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    DESTINATION KEY (locationKey) REFERENCES `restaurant.location`(locationKey)
    LABEL stored_at PROPERTIES ALL COLUMNS
);
6. サプライ チェーンの可視化
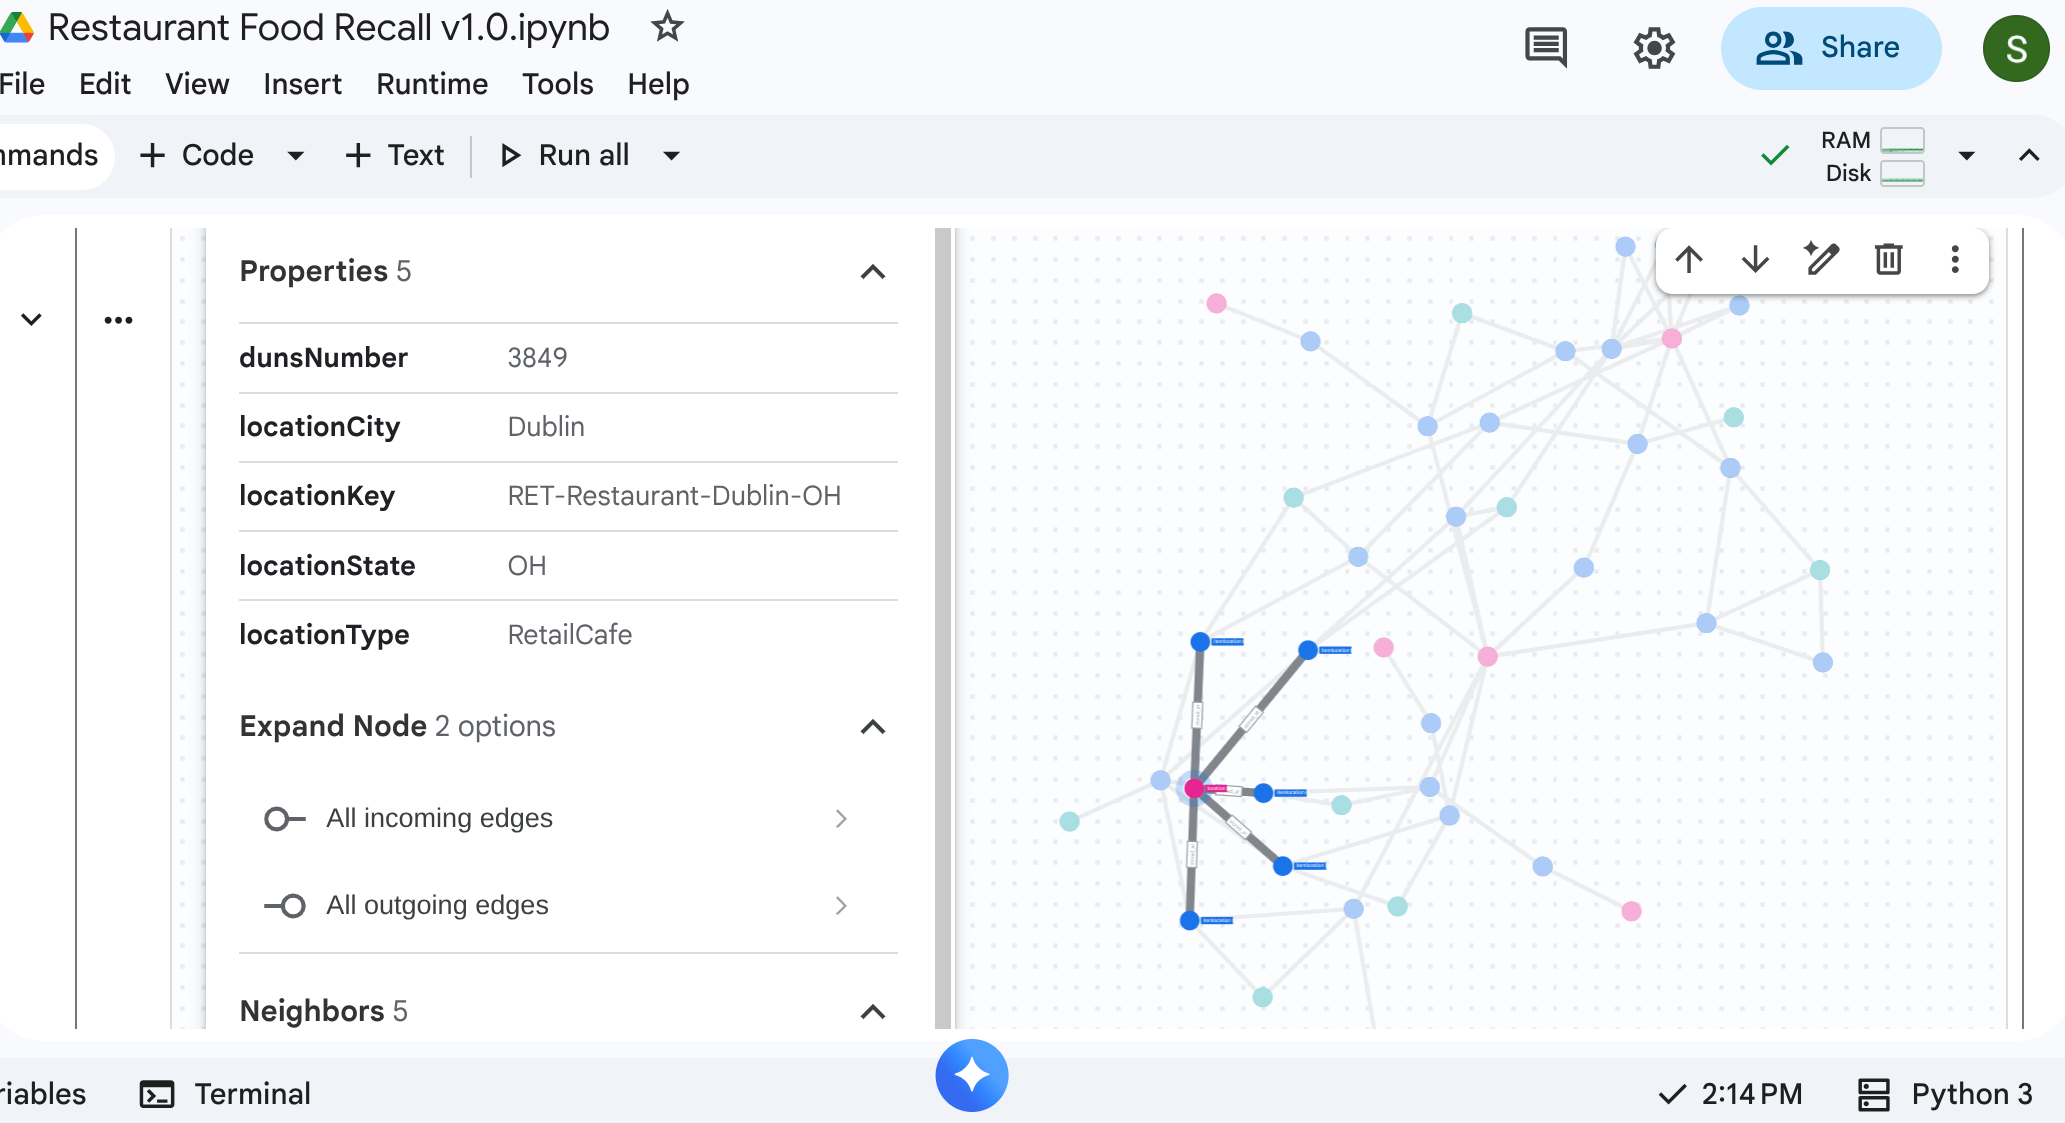
トップダウン トラバーサル クエリを実行すると、サプライ チェーン ネットワーク全体を確認できます。標準のノートブックまたはそれをサポートする UI(%%bigquery --graph など)では、ビジュアル マップが返されます。
絶対グラフクエリを使用して、ノードとエッジの設定を取得します。
注: 前述のように、Google Colab または Colab Enterprise Notebooks でこれを実行するには、BigQuery マジック コマンド %%bigquery を使用することもできます。また、Google Colab または Colab Enterprise Notebooks でグラフを可視化するには、--graph フラグを %%bigquery --graph のように指定します。
%%bigquery  --project=$PROJECT_ID --graph output

Graph restaurant.bombod

match p=(a:itemlocation)-[c:consists_of]->(b:itemlocation)
match q=(a)-[d:stored_at]->(e:location)
optional match z=(f)-[g:makes]-(b)

return to_json(p) as ppath, to_json(q) as qpath, to_json(z) as zpath
出力:
7. ユースケース 1: 上流の苦情を追跡する
シナリオ: お客様が、ニューヨーク店で購入したサンドイッチのチキンの品質について不満を述べています。完成品をさかのぼって、直前の組み立て段階を確認する必要があります。
トラバーサル クエリ
グラフ トラバーサル クエリ形式を使用してクエリを実行します。これは、下流の組み立てから上流の原材料までを関連付ける consists_of エッジを調べます。
%%bigquery --project=$PROJECT_ID --graph

GRAPH restaurant.bombod
MATCH p=(a:itemlocation)-[c:consists_of]->(b:itemlocation)
OPTIONAL MATCH q=(b)-[d:stored_at]-(e)
return to_json(p) as ppath, to_json(q) as qpath
consists_of エッジテーブル(Ingredient -> Finished)の矢印の方向により、アップストリームに向かって検索すると、依存関係にある資料と店舗所在地をすばやく特定するリンクが得られます。
出力: 
8. ユースケース 2: 影響分析
シナリオ: 吹雪により、オハイオ州コロンバスの配送センターが閉鎖されました。すぐに影響を受ける下流の準備品または完成品を特定する必要があります。
トラバーサル クエリ
配送センターを表す特定の location から始めて、そこに保管されている在庫を特定し、それらを必要とする完成品を確認します。
# @title Impact of a storm on a DC

%%bigquery  --project=$PROJECT_ID --graph
Graph restaurant.bombod
match path1=(z:itemlocation)-[m:stored_at]->(dc:location) where dc.locationKey like '%DC-Sysco-Columbus-OH%'
match path2=(z:itemlocation)-[c:consists_of]->(b:itemlocation)
match path3=(b:itemlocation)-[n:makes]->(item:item)
optional match path4=(b)-[p:stored_at]->(q:location)
return to_json(path1) as path1, to_json(path2) as path2,to_json(path3) as path3, to_json(path4) as path4
出力: 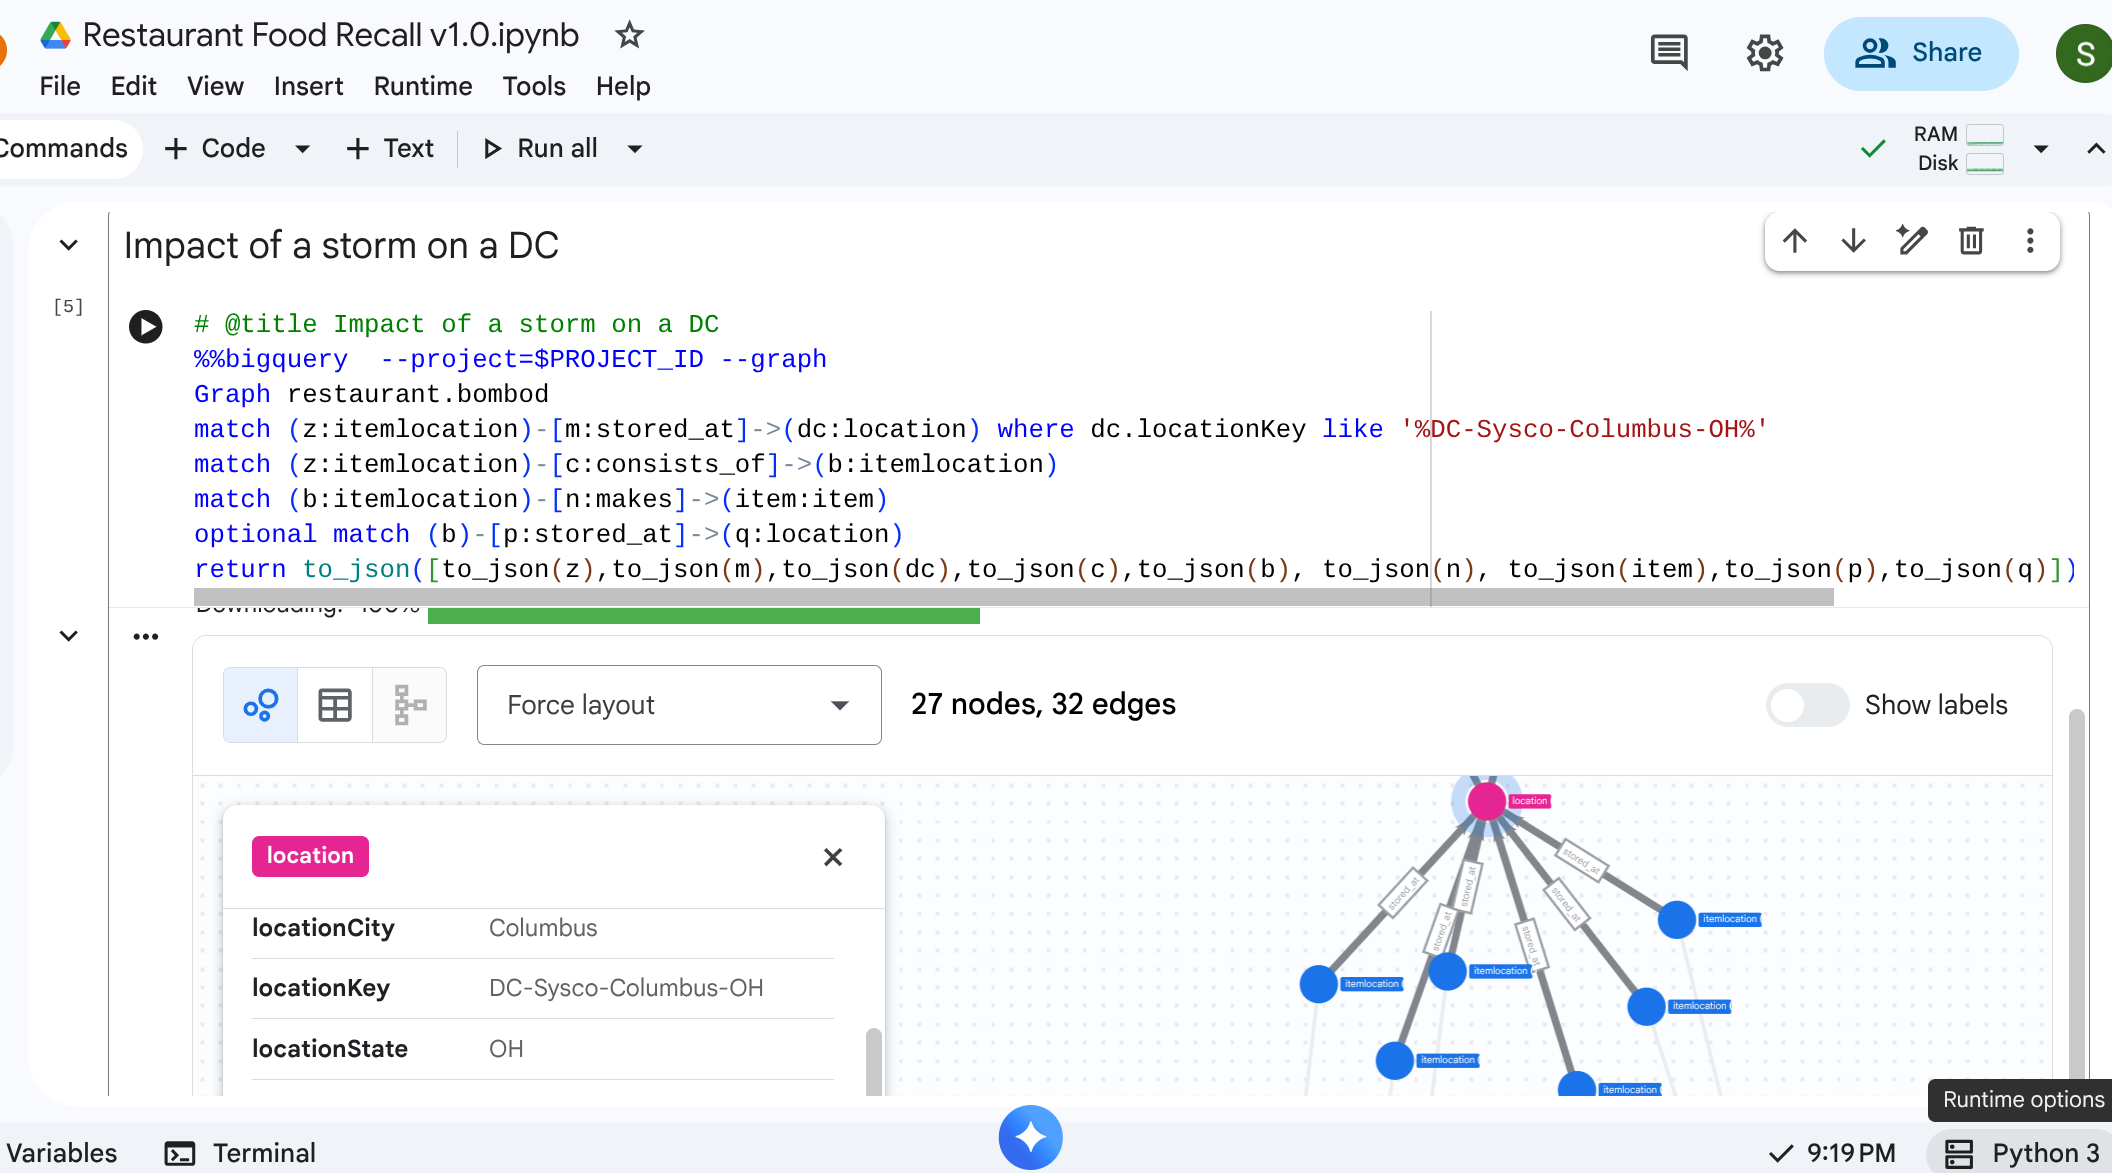
9. ユースケース 3: 下流でのリコール
シナリオ: サプライヤーから、汚染された特定のバッチの商品(サプライヤーの完熟トマト)について通知を受けました。カフェで影響を受ける最終的なメニュー項目をすべて見つける必要があります。
トラバーサル クエリ
汚染された原材料の場所を探し、下流に向かってパス トラバーサルを実行して、最終的に影響を受けたアイテムを見つけます。
%%bigquery  --project=$PROJECT_ID --graph
Graph restaurant.bombod
match path1=(a:itemlocation)-[c:consists_of]->(b:itemlocation)-[e:makes]->(f:item) where f.itemKey like '%Tomato%'
return to_json(path1) as result
このクエリは、「Tomato」とパターンが一致するすべてのアイテムを特定します。これは、上流の関係と絡み合っているため、どのカフェアイテムをリコールする必要があるかを検出するために伝播する強力なマッピングになります。
出力: 
10. クリーンアップ
ワークスペースで残りの料金が発生しないように、チュートリアルの手順を完了したらリソースを削除してください。
DROP SCHEMA `restaurant` CASCADE;
11. まとめ
おめでとうございます!BigQuery Graph を使用してサプライ チェーンをモデル化し、影響分析を実行しました。
まとめ
学習内容:
- 主キー / 外部キーを使用して、グラフ中心のリレーショナル関係を宣言します。
- 統合されたプロパティ グラフを作成する。
- グラフクエリのトラバーサル ロジックを使用して、マルチノード関係を効率的にナビゲートします。
グラフ アーキテクチャに関する分析情報をさらに得るには、Google Cloud のドキュメントをご覧ください。