

1. Introduction
Dans cet atelier de programmation, vous allez apprendre à utiliser BigQuery Graph pour résoudre des problèmes complexes de chaîne d'approvisionnement et de logistique.
Vous allez modéliser le réseau de la chaîne d'approvisionnement d'un restaurant en mettant l'accent sur la sécurité alimentaire et le contrôle qualité. Lorsqu'un problème de sécurité alimentaire survient (par exemple, un ingrédient contaminé provenant d'un fournisseur), il est essentiel d'agir vite. Identifier le "rayon d'impact" et procéder rapidement à un rappel ciblé peut permettre de réduire les coûts et de protéger les clients.

Les modèles relationnels traditionnels nécessitent des opérations JOIN complexes en plusieurs étapes pour suivre les articles à travers plusieurs étapes (fournisseur -> centre de distribution -> magasin d'alimentation -> magasin -> article fini). Avec BigQuery Graph, nous modélisons ces connexions directement, ce qui permet d'effectuer des requêtes intuitives et rapides à l'aide de la norme ISO GQL (Graph Query Language).
Points abordés
- Définir un modèle de graphe sur des tables BigQuery existantes
- Créer un graphe de propriétés dans BigQuery
- Exécuter des requêtes de parcours pour tracer les impacts en amont et en aval
Prérequis
- Projet Google Cloud avec facturation activée
- Google Cloud Shell.
Estimation du coût
Cet atelier devrait coûter moins de 5 USD en frais d'analyse BigQuery, ce qui est largement couvert par les allocations du niveau sans frais pour les nouveaux utilisateurs.
2. Préparation
Ouvrir Cloud Shell
Vous effectuerez la majeure partie du travail dans Cloud Shell, un environnement chargé qui contient tout ce dont vous avez besoin pour utiliser Google Cloud.
- Accédez à la console Google Cloud.
- Cliquez sur l'icône Activer Cloud Shell dans la barre d'outils en haut à droite.
- Cliquez sur Continuer si vous y êtes invité.
Configurer des variables d'environnement
Dans Cloud Shell, définissez l'ID de votre projet pour simplifier les commandes futures.
export PROJECT_ID=$(gcloud config get-value project)
Activer les API
Exécutez la commande suivante pour activer l'API BigQuery requise :
gcloud services enable bigquery.googleapis.com
3. Créer le schéma et les tables
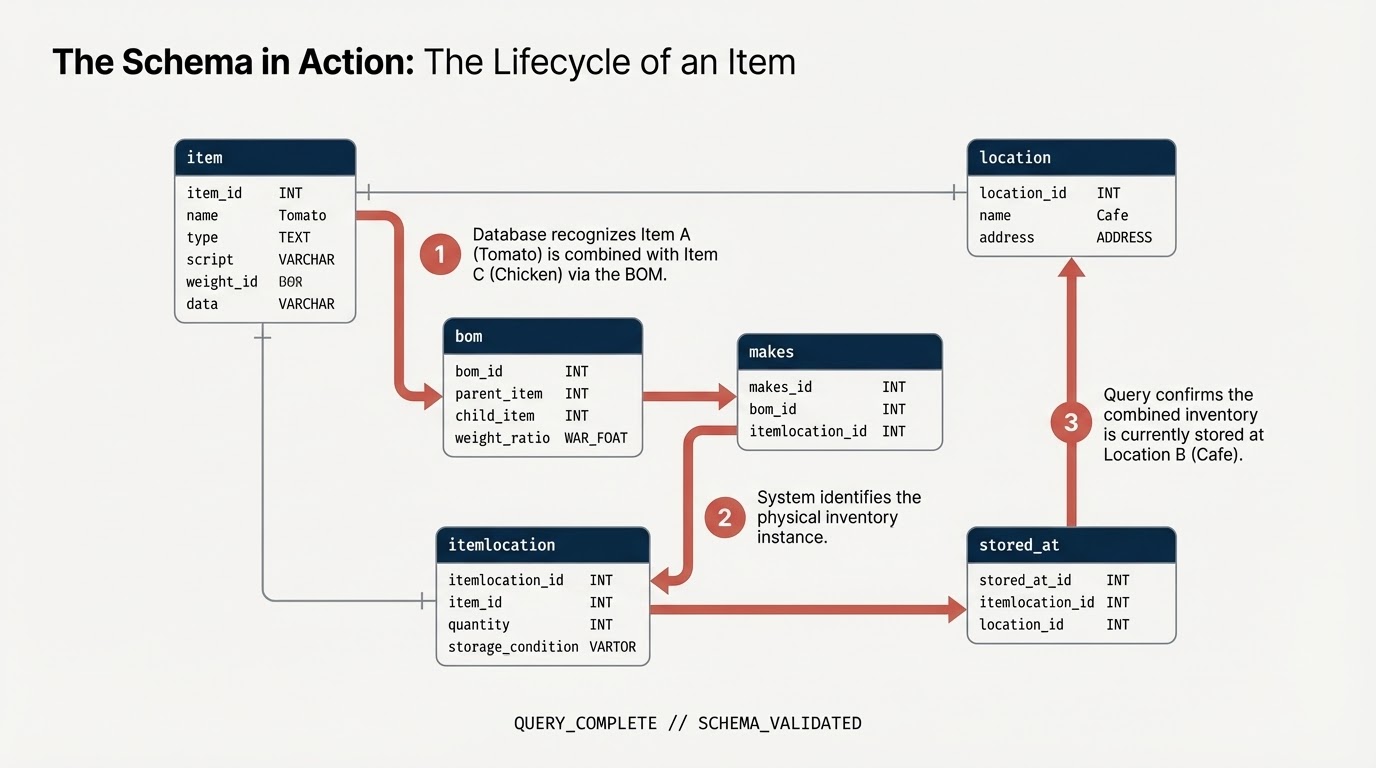
Vous allez créer un ensemble de données et des tables représentant les composants de votre chaîne d'approvisionnement :
item: définition générique de l'article (par exemple, tomate, poulet).location: installations (fournisseurs, centres de distribution, cafés).itemlocation: table d'intersection représentant les emplacements d'inventaire.bom: nomenclature (définit les relations de poids, par exemple, l'élément A entre dans l'élément B).makes: mappeitemlocationversitem.stored_at: mappeitemlocationverslocation.
Créer un ensemble de données
Vous pouvez exécuter les commandes SQL de cet atelier à l'aide de Cloud Shell ou de la console BigQuery.
Pour utiliser la console BigQuery :
- Ouvrez la console BigQuery dans un nouvel onglet.
- Collez chaque extrait SQL de cet atelier dans l'éditeur, puis cliquez sur le bouton Exécuter pour l'exécuter.

Exécutez la commande suivante dans Cloud Shell ou utilisez la console BigQuery pour créer le schéma. Vous allez utiliser des variables de nœud dans votre code SQL.
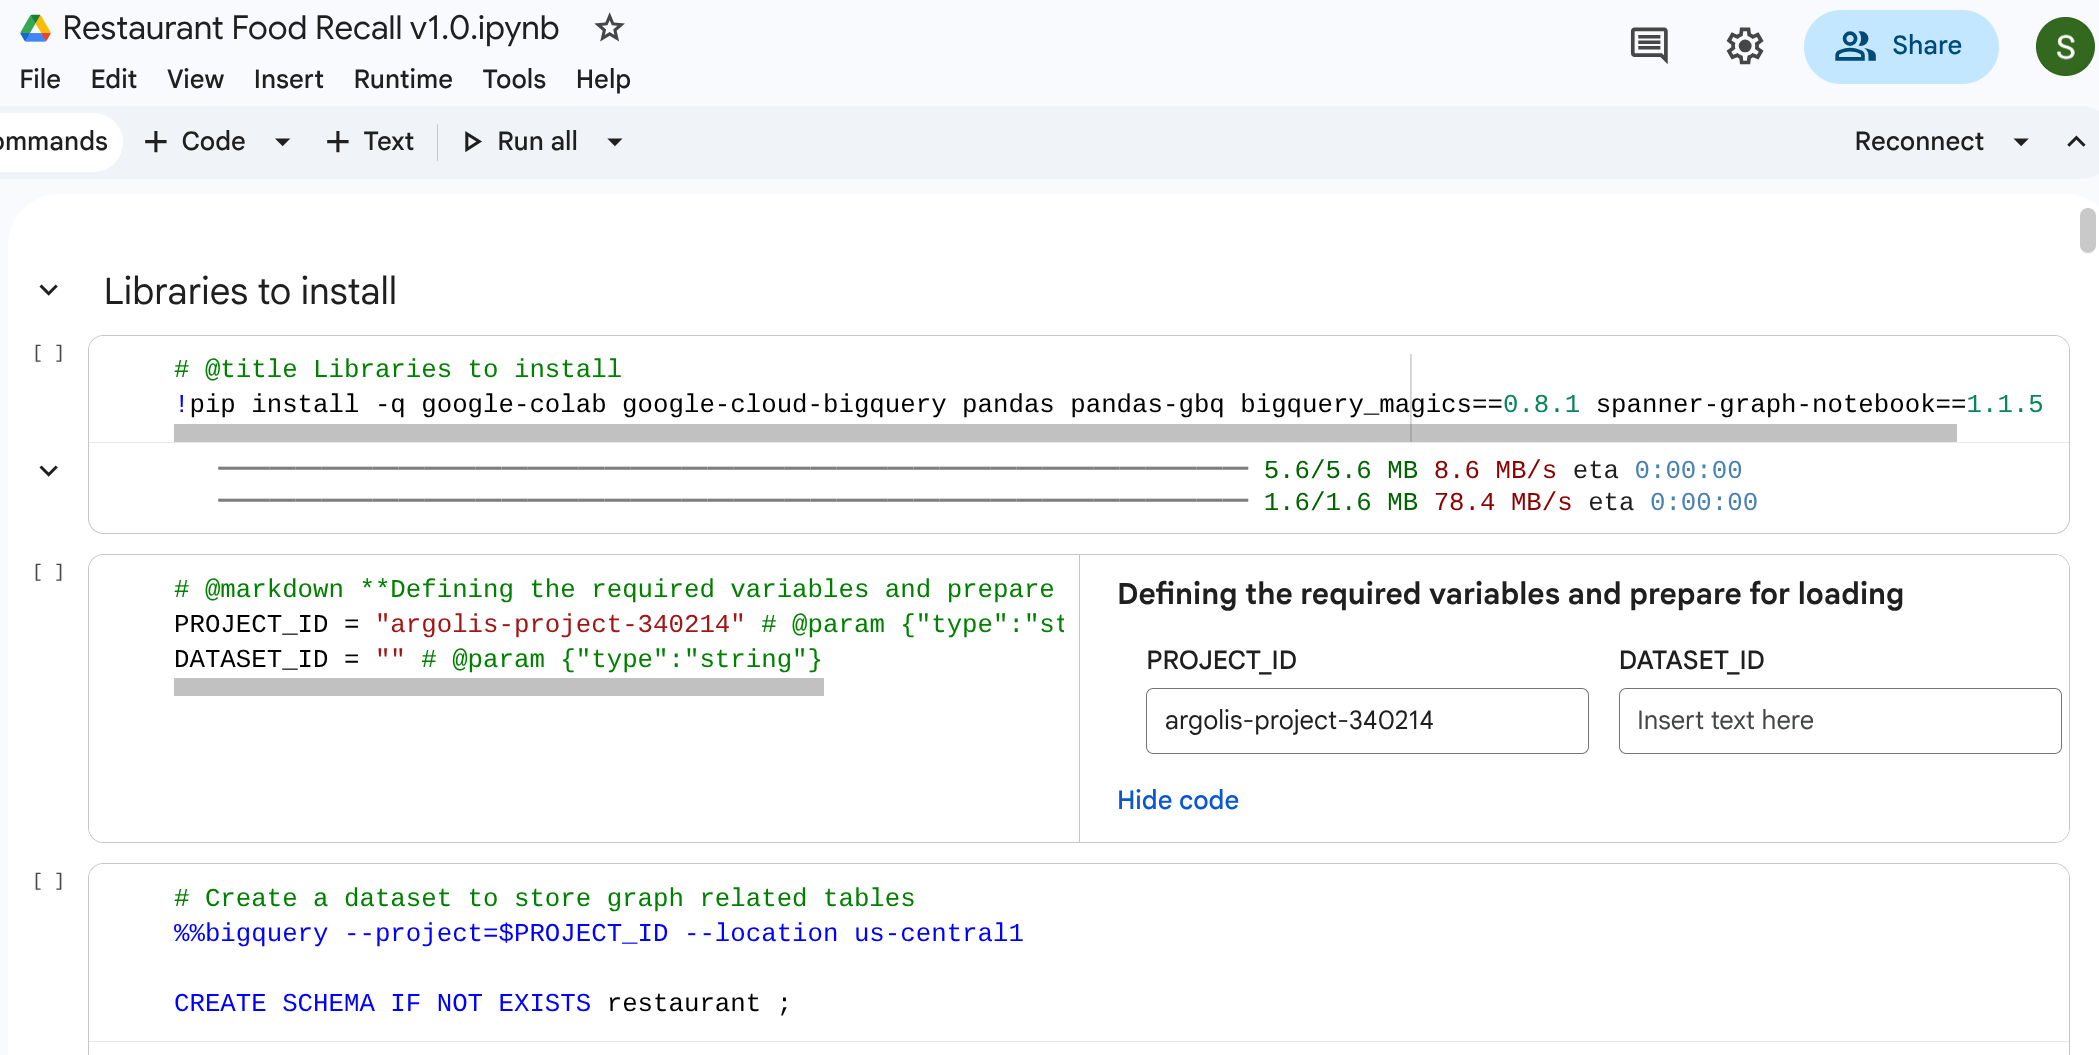
Remarque : (1) Pour exécuter cette opération dans Google Colab, vous pouvez également utiliser les commandes magiques BigQuery : %%bigquery. L'extrait de code suivant crée le schéma "restaurant" dans votre projet pour héberger vos données de graphe. (2) Vous devrez utiliser %%bigquery –project <PROJECT_ID> si vous exécutez la requête depuis Google Colab. Assurez-vous que le champ PROJECT_ID est mappé au projet que vous souhaitez utiliser : PROJECT_ID = "argolis-project-340214" # @param {"type":"string"} (3) Si vous utilisez Colab, vous devrez installer certaines bibliothèques en fonction de vos besoins. Si vous comptez utiliser la visualisation de graphes, assurez-vous d'installer la bibliothèque spanner-graph-notebook==1.1.5 à l'aide de pip.
%%bigquery --project=$PROJECT_ID
CREATE SCHEMA IF NOT EXISTS restaurant ;
Créer des tables
Exécutez le code SQL suivant pour créer les tables.
%%bigquery --project=$PROJECT_ID
-- 1. Item Table
DROP TABLE IF EXISTS `restaurant.item`;
CREATE TABLE `restaurant.item` (
  itemKey STRING,
  itemName STRING,
  itemCategory STRING,
  shelfLifeDays INT64,
  PRIMARY KEY (itemKey) NOT ENFORCED
);

-- 2. Location Table
DROP TABLE IF EXISTS `restaurant.location`;
CREATE TABLE `restaurant.location` (
  locationKey STRING,
  locationType STRING,
  locationCity STRING,
  locationState STRING,
  dunsNumber INT64,
  PRIMARY KEY (locationKey) NOT ENFORCED
);
-- 3. ItemLocation Table
DROP TABLE IF EXISTS `restaurant.itemlocation`;
CREATE TABLE `restaurant.itemlocation` (
  itemLocationKey STRING,
  itemKey STRING,
  locationKey STRING,
  variants INT64,
  PRIMARY KEY (itemLocationKey) NOT ENFORCED,
  -- Foreign Key Definitions
  FOREIGN KEY (itemKey) REFERENCES `restaurant.item`(itemKey) NOT ENFORCED,
  FOREIGN KEY (locationKey) REFERENCES `restaurant.location`(locationKey) NOT ENFORCED
);

-- 4. BOM Table
DROP TABLE IF EXISTS `restaurant.bom`;
CREATE TABLE `restaurant.bom` (
  bomKey INT64,
  parentItemLocation STRING,
  childItemLocation STRING,
  childQuantity FLOAT64,
  PRIMARY KEY (bomKey) NOT ENFORCED
);

-- 5. Makes Table
DROP TABLE IF EXISTS `restaurant.makes`;
CREATE TABLE `restaurant.makes` (
  itemLocationKey STRING,
  itemKey STRING,
  locationKey STRING,
  variants INT64,
  PRIMARY KEY (itemLocationKey) NOT ENFORCED
);

DROP TABLE IF EXISTS `restaurant.stored_at`;
CREATE TABLE `restaurant.stored_at` (
  itemLocationKey STRING,
  itemKey STRING,
  locationKey STRING,
  variants INT64,
  PRIMARY KEY (itemLocationKey) NOT ENFORCED
);
4. Chargement des exemples de données…
Pour que cet atelier soit entièrement autonome, vous allez remplir les tables avec des exemples de données à l'aide d'instructions SQL LOAD DATA pures. Il représente un réseau commençant par un fournisseur, traversant un centre de distribution et une cuisine centrale, et se terminant dans un café.
Exécutez les requêtes SQL suivantes pour charger les données :
Remarque : Vous pouvez omettre %%bigquery si vous exécutez directement dans BigQuery Studio.
%%bigquery --project=$PROJECT_ID
-- Load Item
LOAD DATA OVERWRITE `restaurant.item`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/item2.csv'], skip_leading_rows = 1);

-- Load Location
LOAD DATA OVERWRITE `restaurant.location`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/location.csv'], skip_leading_rows = 1);

-- Load ItemLocation
LOAD DATA OVERWRITE `restaurant.itemlocation`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/itemlocation.csv'], skip_leading_rows = 1);

-- Load BOM
LOAD DATA OVERWRITE `restaurant.bom`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/bom2.csv'], skip_leading_rows = 1);

-- Load Makes
LOAD DATA OVERWRITE `restaurant.makes`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/makes.csv'], skip_leading_rows = 1);

-- Load StoredAt
LOAD DATA OVERWRITE `restaurant.stored_at`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/itemlocation.csv'], skip_leading_rows = 1);
5. Ajouter des contraintes et définir un graphique
Avant de créer le graphe, vous déclarez les relations sémantiques à l'aide de contraintes de clé primaire et de clé étrangère SQL standards. Ils aident BigQuery à comprendre les identifiants de nœud et à connecter les tables d'arêtes aux tables de nœuds.
Créer un graphique de propriété
Vous allez maintenant réunir ces tables dans une structure de graphe cohérente appelée restaurant.bombod.
Vous définissez :
- Nœuds :
item,location,itemlocation - Edges :
makes,stored_atetconsists_of(BOM)
%%bigquery --project=$PROJECT_ID

CREATE OR REPLACE PROPERTY GRAPH `restaurant.bombod`
NODE TABLES (
  `restaurant.item` KEY (itemKey) LABEL item PROPERTIES ALL COLUMNS,
  `restaurant.location` KEY (locationKey) LABEL location PROPERTIES ALL COLUMNS,
  `restaurant.itemlocation` KEY (itemLocationKey) LABEL itemlocation PROPERTIES ALL COLUMNS
)
EDGE TABLES (
  `restaurant.makes`
    KEY (itemLocationKey)
    SOURCE KEY (itemLocationKey) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    DESTINATION KEY (itemKey) REFERENCES `restaurant.item`(itemKey)
    LABEL makes PROPERTIES ALL COLUMNS,

  `restaurant.bom`
    KEY (bomKey)
    SOURCE KEY (childItemLocation) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    DESTINATION KEY (parentItemLocation) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    LABEL consists_of PROPERTIES ALL COLUMNS,

  `restaurant.stored_at`
    KEY (itemLocationKey)
    SOURCE KEY (itemLocationKey) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    DESTINATION KEY (locationKey) REFERENCES `restaurant.location`(locationKey)
    LABEL stored_at PROPERTIES ALL COLUMNS
);
6. Visualiser la chaîne d'approvisionnement
Vous pouvez exécuter une requête de parcours de haut en bas pour afficher l'ensemble du réseau de la chaîne d'approvisionnement. Dans un notebook standard ou une UI compatible (comme %%bigquery --graph), cela renvoie une carte visuelle.
Utilisez des requêtes de graphe absolues pour configurer les nœuds et les arêtes.
Remarque : Comme indiqué précédemment, pour exécuter cette opération dans Google Colab ou Colab Enterprise Notebooks, vous pouvez également utiliser les commandes magiques BigQuery : %%bigquery. De plus, pour visualiser le graphique dans Google Colab ou Colab Enterprise Notebooks, incluez l'option –graph comme suit : %%bigquery –graph.
%%bigquery  --project=$PROJECT_ID --graph output

Graph restaurant.bombod

match p=(a:itemlocation)-[c:consists_of]->(b:itemlocation)
match q=(a)-[d:stored_at]->(e:location)
optional match z=(f)-[g:makes]-(b)

return to_json(p) as ppath, to_json(q) as qpath, to_json(z) as zpath
Résultat :

7. Cas d'utilisation 1 : Suivre une réclamation en amont
Scénario : Un client se plaint de la qualité du poulet dans son sandwich au magasin de New York. Vous devez remonter l'article fini pour voir ses étapes d'assemblage immédiates.
Requête de balayage
Exécutez la requête en utilisant le format de requête de balayage de graphe. Cela examine les bords consists_of qui relient les assemblages en aval aux ingrédients en amont.
%%bigquery --project=$PROJECT_ID --graph

GRAPH restaurant.bombod
MATCH p=(a:itemlocation)-[c:consists_of]->(b:itemlocation)
OPTIONAL MATCH q=(b)-[d:stored_at]-(e)
return to_json(p) as ppath, to_json(q) as qpath
En raison de la direction de la flèche dans la table des bords consists_of (Ingredient -> Finished), une recherche en amont génère des liens qui isolent rapidement les matériaux et les emplacements de stockage dépendants.
Résultat : 
8. Cas d'utilisation 2 : Analyse d'impact
Scénario : Une tempête de neige a entraîné la fermeture du centre de distribution de Columbus, dans l'Ohio. Vous devez savoir quelles préparations en aval ou quels articles finis sont immédiatement concernés.
Requête de balayage
Vous commencez par le location spécifique représentant le centre de distribution, vous identifiez l'inventaire qui y est stocké et vous voyez quels articles finis en ont besoin.
# @title Impact of a storm on a DC

%%bigquery  --project=$PROJECT_ID --graph
Graph restaurant.bombod
match path1=(z:itemlocation)-[m:stored_at]->(dc:location) where dc.locationKey like '%DC-Sysco-Columbus-OH%'
match path2=(z:itemlocation)-[c:consists_of]->(b:itemlocation)
match path3=(b:itemlocation)-[n:makes]->(item:item)
optional match path4=(b)-[p:stored_at]->(q:location)
return to_json(path1) as path1, to_json(path2) as path2,to_json(path3) as path3, to_json(path4) as path4
Résultat : 
9. Cas d'utilisation 3 : Rappel en aval
Scénario : Un fournisseur vous informe qu'un lot spécifique de produits est contaminé : Tomates mûries sur pied du fournisseur. Vous devez trouver tous les éléments de menu finaux concernés dans les cafés.
Requête de balayage
Vous recherchez l'emplacement de la matière première contaminée, puis vous effectuez un parcours en aval pour trouver les éléments finaux concernés.
%%bigquery  --project=$PROJECT_ID --graph
Graph restaurant.bombod
match path1=(a:itemlocation)-[c:consists_of]->(b:itemlocation)-[e:makes]->(f:item) where f.itemKey like '%Tomato%'
return to_json(path1) as result
Cette requête localise tous les éléments qui correspondent au modèle "Tomato" et qui sont liés à la relation en amont, ce qui en fait un mappage puissant qui se propage pour découvrir quels éléments du café doivent être rappelés.
Résultat : 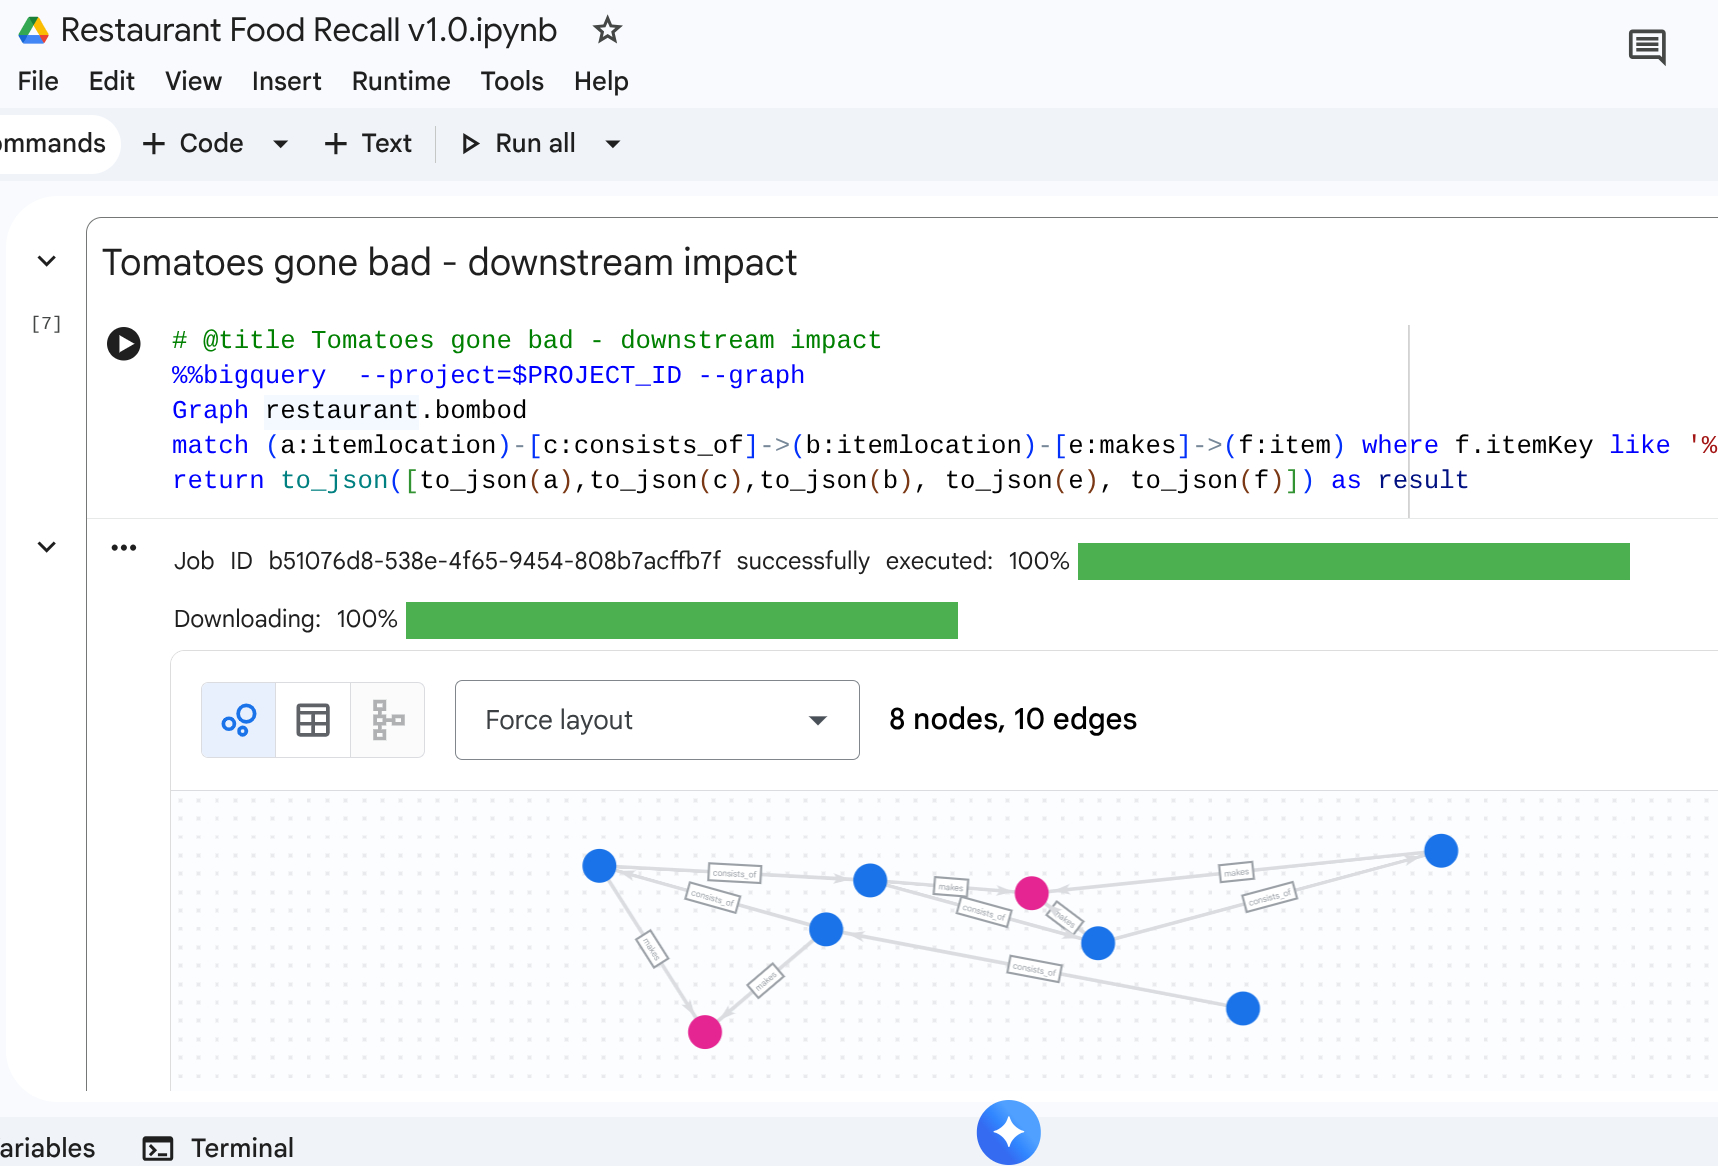
10. Effectuer un nettoyage
Supprimez les ressources une fois que vous avez terminé les étapes du tutoriel pour éviter tout frais résiduel dans votre espace de travail.
DROP SCHEMA `restaurant` CASCADE;
11. Conclusion
Félicitations ! Vous avez modélisé une chaîne d'approvisionnement et exécuté une analyse d'impact à l'aide de BigQuery Graph.
Conclusion
Vous savez désormais :
- Déclarez des relations relationnelles centrées sur les graphes avec des clés primaires/étrangères.
- Créez un graphique de propriétés unifié.
- Parcourez efficacement les relations entre plusieurs nœuds à l'aide de la logique de balayage des requêtes de graphe.
Pour en savoir plus sur l'architecture des graphiques, consultez la documentation Google Cloud.