

۱. مقدمه
در این آموزش، یاد خواهید گرفت که چگونه از BigQuery Graph برای حل کردن مشکلات پیچیده زنجیره تأمین و لجستیک استفاده کنید.
تو یک شبکه زنجیره تأمین رستوران را با تمرکز بر ایمنی غذا و کنترل کیفیت مدلسازی خواهی کرد. وقتی مشکلی در ایمنی غذا پیش میآید—مثلاً ماده آلودهای از تأمینکننده—زمان اهمیت زیادی دارد. شناسایی «شعاع انفجار» و اجرای سریع فراخوانی دقیق میتواند هزینهها را کاهش دهد و از مشتریان محافظت کند.

مدلهای رابطهای سنتی برای ردیابی اقلام در مراحل متعدد (تأمینکننده -> مرکز توزیع -> فروشگاه مواد غذایی -> فروشگاه -> محصول نهایی) به عملیات پیچیده و چندمرحلهای JOIN نیاز دارند. با BigQuery Graph، این اتصالات را مستقیماً مدلسازی میکنیم و پُرسمانهای شهودی و سریع را بااستفاده از استاندارد ISO GQL (زبان پُرسمان گراف) امکانپذیر میکنیم.
آنچه خواهید آموخت
- چگونه یک مدل گراف را روی جدولهای BigQuery موجود تعریف کنید.
- نحوه ایجاد کردن «گراف خصوصیت» در BigQuery.
- نحوه اجرای پُرسمانهای پیمایشی برای ردیابی تأثیرات بالادستی و پاییندستی.
آنچه نیاز خواهید داشت
- یک پروژه Google Cloud با صورتحساب فعال.
- Google Cloud Shell.
برآورد هزینه
انتظار میرود هزینه این آزمایشگاه کمتر از ۵ دلار امریکا در کارمزدهای تجزیهوتحلیل BigQuery باشد که بهخوبی در محدوده تخصیصهای «رده رایگان» برای کاربران جدید قرار دارد.
۲. راهاندازی و الزامات
باز کردن Cloud Shell
بخش عمده کار را در Cloud Shell انجام خواهید داد، محیطی بارشده که هرآنچه را برای استفاده از Google Cloud نیاز دارید دراختیارتان قرار میدهد.
- به کنسول Google Cloud بروید.
- روی نماد فعال کردن Cloud Shell در نوار ابزار بالا سمت چپ کلیک کنید.
- درصورت درخواست، روی ادامه کلیک کنید.
راهاندازی متغیرهای محیطی
در Cloud Shell، «شناسه پروژه» خود را تنظیم کنید تا فرمانهای آینده سادهتر شود.
export PROJECT_ID=$(gcloud config get-value project)
فعال کردن میاناهای برنامهسازی کاربردی
این فرمان را برای فعال کردن میانای برنامهسازی کاربردی BigQuery موردنیاز اجرا کنید:
gcloud services enable bigquery.googleapis.com
۳. درحال ایجاد طرحواره و جدولها
You will create a dataset and tables representing your supply chain components:
item: تعریف عمومی مورد (مثلاً گوجهفرنگی، مرغ).location: تأسیسات (تأمینکنندگان، مراکز توزیع، کافهها).itemlocation: جدول تقاطع که مکانهای موجودی را نشان میدهد.bom: درخت محصول (روابط وزنی را تعریف میکند، مثلاً «مورد الف» در «مورد ب» قرار میگیرد).makes: Mapsitemlocationبهitem.stored_at: Mapsitemlocationبهlocation.
ایجاد مجموعه داده
میتوانید فرمانهای SQL را در این آزمایشگاه بااستفاده از Cloud Shell یا کنسول BigQuery اجرا کنید.
برای استفاده از کنسول BigQuery:
- کنسول BigQuery را در برگه جدیدی باز کنید.
- هر قطعه SQL از این آزمایشگاه را در ویرایشگر جایگذاری کنید، سپس روی دکمه اجرا کلیک کنید تا اجرا شود.
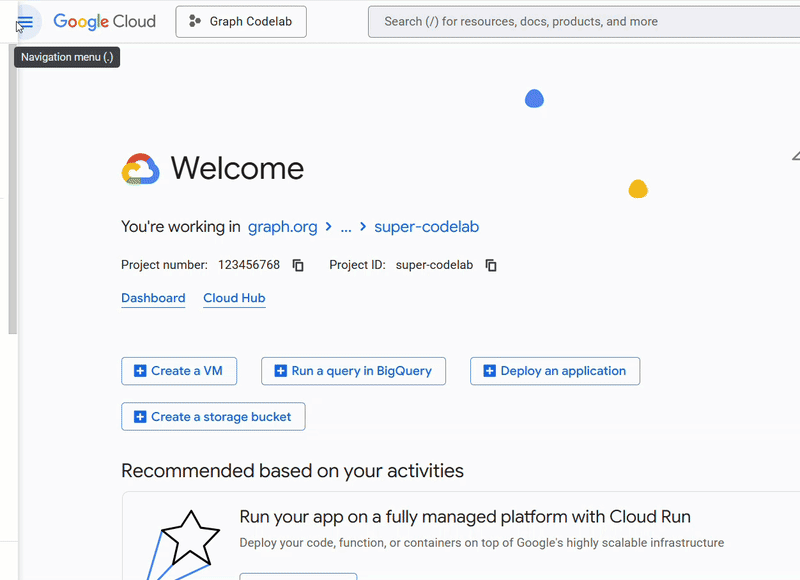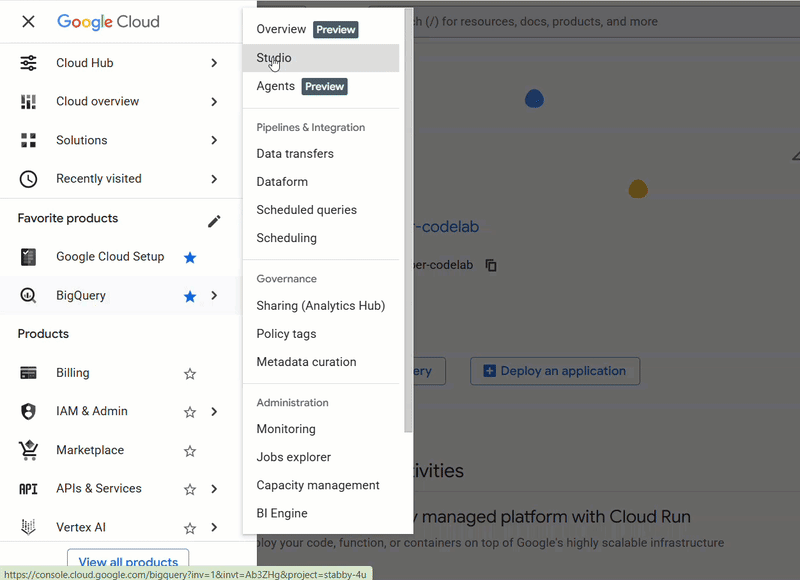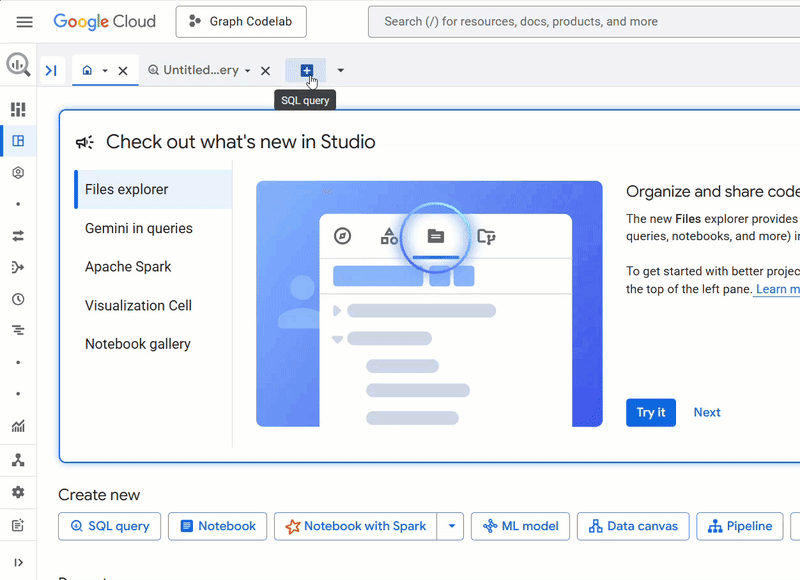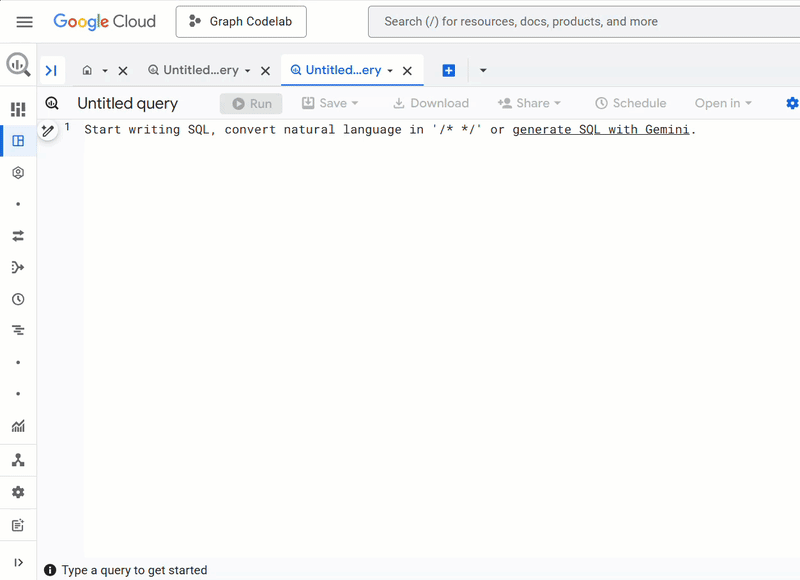
فرمان زیر را در Cloud Shell اجرا کنید یا از «کنسول BigQuery» برای ایجاد طرح استفاده کنید. از متغیرهای گره در SQL خود استفاده خواهید کرد.

توجه: (۱) برای اجرای این دستور در Google Colab، میتوانید از دستورات جادویی BigQuery نیز استفاده کنید: %%bigquery قطعه کد زیر طرح رستوران را در پروژه شما ایجاد میکند تا دادههای گراف شما را در خود جای دهد. (۲) اگر از Google Colab اجرا میکنید، باید از %%bigquery –project <PROJECT_ID> استفاده کنید. مطمئن شوید فیلد PROJECT_ID به پروژه مناسبی که قصد استفاده از آن را دارید نگاشت شده باشد: PROJECT_ID = "argolis-project-340214" # @param {"type":"string"} (3) اگر از colab استفاده میکنید، بسته به الزاماتتان باید برخیاز کتابخانهها را نصب کنید. اگر میخواهید از تجسم گراف استفاده کنید، حتماً کتابخانه spanner-graph-notebook==1.1.5 را با pip نصب کنید
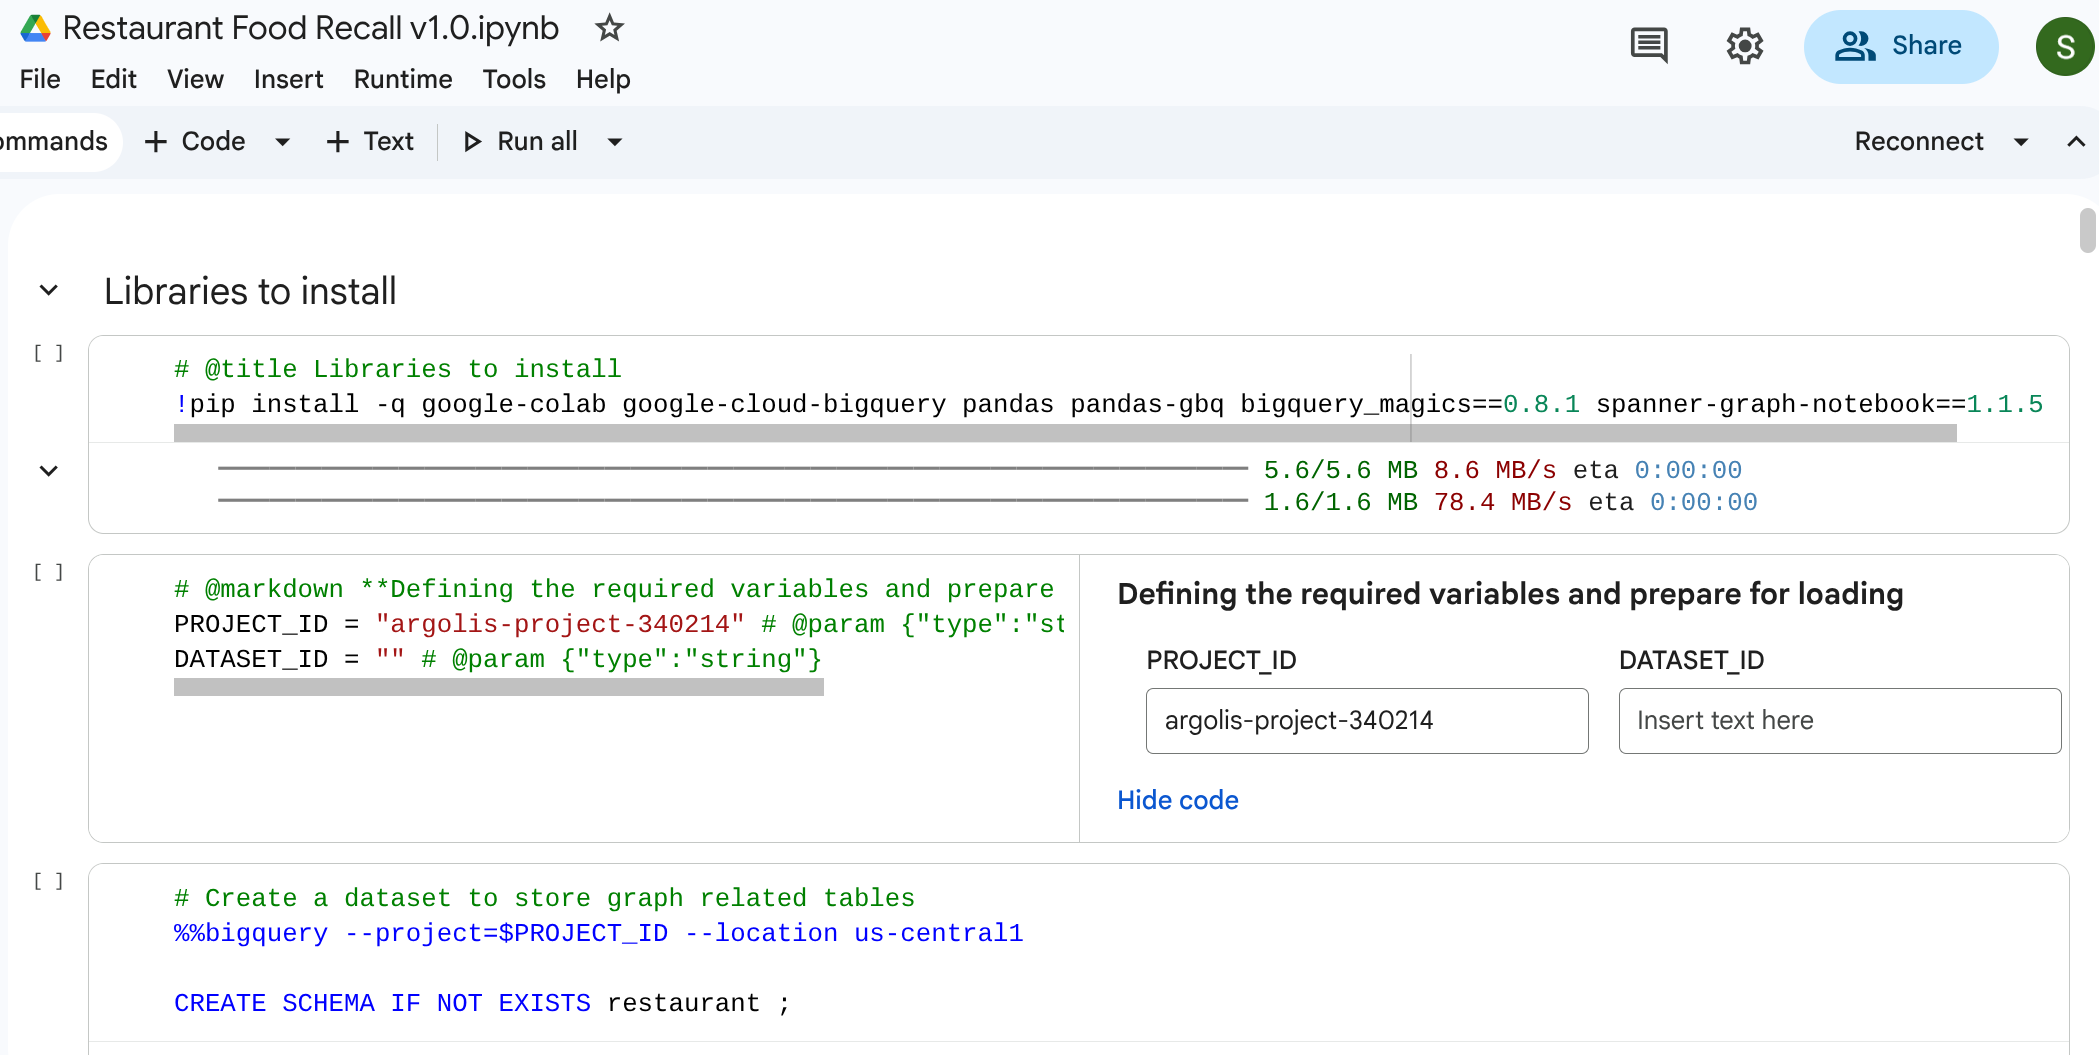
%%bigquery --project=$PROJECT_ID
CREATE SCHEMA IF NOT EXISTS restaurant ;
ایجاد جدول
کد SQL زیر را برای ساختن جدولها اجرا کنید.
%%bigquery --project=$PROJECT_ID
-- 1. Item Table
DROP TABLE IF EXISTS `restaurant.item`;
CREATE TABLE `restaurant.item` (
  itemKey STRING,
  itemName STRING,
  itemCategory STRING,
  shelfLifeDays INT64,
  PRIMARY KEY (itemKey) NOT ENFORCED
);

-- 2. Location Table
DROP TABLE IF EXISTS `restaurant.location`;
CREATE TABLE `restaurant.location` (
  locationKey STRING,
  locationType STRING,
  locationCity STRING,
  locationState STRING,
  dunsNumber INT64,
  PRIMARY KEY (locationKey) NOT ENFORCED
);
-- 3. ItemLocation Table
DROP TABLE IF EXISTS `restaurant.itemlocation`;
CREATE TABLE `restaurant.itemlocation` (
  itemLocationKey STRING,
  itemKey STRING,
  locationKey STRING,
  variants INT64,
  PRIMARY KEY (itemLocationKey) NOT ENFORCED,
  -- Foreign Key Definitions
  FOREIGN KEY (itemKey) REFERENCES `restaurant.item`(itemKey) NOT ENFORCED,
  FOREIGN KEY (locationKey) REFERENCES `restaurant.location`(locationKey) NOT ENFORCED
);

-- 4. BOM Table
DROP TABLE IF EXISTS `restaurant.bom`;
CREATE TABLE `restaurant.bom` (
  bomKey INT64,
  parentItemLocation STRING,
  childItemLocation STRING,
  childQuantity FLOAT64,
  PRIMARY KEY (bomKey) NOT ENFORCED
);

-- 5. Makes Table
DROP TABLE IF EXISTS `restaurant.makes`;
CREATE TABLE `restaurant.makes` (
  itemLocationKey STRING,
  itemKey STRING,
  locationKey STRING,
  variants INT64,
  PRIMARY KEY (itemLocationKey) NOT ENFORCED
);

DROP TABLE IF EXISTS `restaurant.stored_at`;
CREATE TABLE `restaurant.stored_at` (
  itemLocationKey STRING,
  itemKey STRING,
  locationKey STRING,
  variants INT64,
  PRIMARY KEY (itemLocationKey) NOT ENFORCED
);
۴. درحال بار کردن دادههای نمونهگیریشده
برای اینکه این آزمایشگاه کاملاً مستقل باشد، جدولها را با دادههای نمونه بااستفاده از دستورات SQL LOAD DATA خالص پر خواهید کرد. این نشاندهنده شبکهای است که با تأمینکننده شروع میشود، از مرکز توزیع (DC) و آشپزخانه مرکزی عبور میکند، و در کافه خردهفروشی فرود میآید.
برای بار کردن دادهها، پُرسمانهای SQL زیر را اجرا کنید:
توجه: اگر مستقیماً در bigquery studio اجرا میکنید، میتوانید %%bigquery را حذف کنید
%%bigquery --project=$PROJECT_ID
-- Load Item
LOAD DATA OVERWRITE `restaurant.item`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/item2.csv'], skip_leading_rows = 1);

-- Load Location
LOAD DATA OVERWRITE `restaurant.location`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/location.csv'], skip_leading_rows = 1);

-- Load ItemLocation
LOAD DATA OVERWRITE `restaurant.itemlocation`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/itemlocation.csv'], skip_leading_rows = 1);

-- Load BOM
LOAD DATA OVERWRITE `restaurant.bom`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/bom2.csv'], skip_leading_rows = 1);

-- Load Makes
LOAD DATA OVERWRITE `restaurant.makes`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/makes.csv'], skip_leading_rows = 1);

-- Load StoredAt
LOAD DATA OVERWRITE `restaurant.stored_at`
FROM FILES (format = 'CSV', uris = ['gs://supply_chain_demo/itemlocation.csv'], skip_leading_rows = 1);
۵. افزودن محدودیتها و تعریف نمودار
قبلاز ساختن نمودار، روابط معنایی را بااستفاده از محدودیتهای استاندارد «کلید اصلی» و «کلید خارجی» SQL اعلام میکنید. اینها به BigQuery کمک میکنند تا شناسههای گره را درک کند و جدولهای یال را به جدولهای گره متصل کند.
ایجاد نمودار دارایی
اکنون، این جدولها را در یک ساختار «گراف» منسجم واحد به نام restaurant.bombod متحد میکنید.
شما تعریف میکنید:
- گرهها:
item،location،itemlocation - Edges:
makes،stored_at، وconsists_of(BOM)
%%bigquery --project=$PROJECT_ID

CREATE OR REPLACE PROPERTY GRAPH `restaurant.bombod`
NODE TABLES (
  `restaurant.item` KEY (itemKey) LABEL item PROPERTIES ALL COLUMNS,
  `restaurant.location` KEY (locationKey) LABEL location PROPERTIES ALL COLUMNS,
  `restaurant.itemlocation` KEY (itemLocationKey) LABEL itemlocation PROPERTIES ALL COLUMNS
)
EDGE TABLES (
  `restaurant.makes`
    KEY (itemLocationKey)
    SOURCE KEY (itemLocationKey) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    DESTINATION KEY (itemKey) REFERENCES `restaurant.item`(itemKey)
    LABEL makes PROPERTIES ALL COLUMNS,

  `restaurant.bom`
    KEY (bomKey)
    SOURCE KEY (childItemLocation) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    DESTINATION KEY (parentItemLocation) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    LABEL consists_of PROPERTIES ALL COLUMNS,

  `restaurant.stored_at`
    KEY (itemLocationKey)
    SOURCE KEY (itemLocationKey) REFERENCES `restaurant.itemlocation`(itemLocationKey)
    DESTINATION KEY (locationKey) REFERENCES `restaurant.location`(locationKey)
    LABEL stored_at PROPERTIES ALL COLUMNS
);
۶. دیداریسازی زنجیره تأمین
میتوانید پُرسمان پیمایش بالا به پایین اجرا کنید تا کل شبکه زنجیره تأمین را ببینید. در دفتر یادداشت استاندارد یا میانای کاربری که از آن پشتیبانی میکند (مثل %%bigquery --graph)، این کار نقشه دیداری برمیگرداند.
برای دریافت گرهها و راهاندازی لبهها، از پُرسمانهای مطلق نمودار استفاده کنید.
توجه: همانطور که قبلاً ذکر شد، برای اجرای این مورد در Google Colab یا Colab Enterprise Notebooks، میتوانید از فرمانهای جادویی BigQuery نیز استفاده کنید: %%bigquery همچنین برای تجسم گراف در Google Colab یا Colab Enterprise Notebooks، پرچم –graph را بهصورت زیر اضافه کنید: %%bigquery –graph
%%bigquery  --project=$PROJECT_ID --graph output

Graph restaurant.bombod

match p=(a:itemlocation)-[c:consists_of]->(b:itemlocation)
match q=(a)-[d:stored_at]->(e:location)
optional match z=(f)-[g:makes]-(b)

return to_json(p) as ppath, to_json(q) as qpath, to_json(z) as zpath
خروجی:

۷. مورد استفاده ۱: ردیابی شکایت بالادستی
سناریو: مشتریای از کیفیت مرغ در ساندویچش در فروشگاه نیویورک شکایت میکند. باید مورد تکمیلشده را بهعقب ردیابی کنید تا مراحل مونتاژ فوری آن را ببینید.
پُرسمان پیمایش
پُرسمان را بااستفاده از قالب پُرسمان «پیمایش گراف» اجرا کنید. این گزینه consists_of لبهای را بررسی میکند که مجموعههای پاییندست را به مواد تشکیلدهنده بالادست مرتبط میکند.
%%bigquery --project=$PROJECT_ID --graph

GRAPH restaurant.bombod
MATCH p=(a:itemlocation)-[c:consists_of]->(b:itemlocation)
OPTIONAL MATCH q=(b)-[d:stored_at]-(e)
return to_json(p) as ppath, to_json(q) as qpath
بهدلیل جهت پیکان در consists_of جدول لبه (Ingredient -> Finished)، جستجوی جریان بالادست پیوندهایی را ارائه میدهد که بهسرعت مواد وابسته و مکانهای ذخیرهسازی را جدا میکند.
خروجی: 
۸. مورد استفاده ۲: تحلیل تأثیر
سناریو: طوفان برف باعث تعطیلی «مرکز توزیع» در کلمبوس، اوهایو شده است. باید بدانید کدام آمادهسازیهای پاییندستی یا اقلام نهایی فوراً تحتتأثیر قرار میگیرند.
پُرسمان پیمایش
از location خاصی که نشاندهنده «مرکز توزیع» است شروع میکنید، موجودی ذخیرهشده در آنجا را شناسایی میکنید، و میبینید کدام اقلام تکمیلشده به آنها نیاز دارند.
# @title Impact of a storm on a DC

%%bigquery  --project=$PROJECT_ID --graph
Graph restaurant.bombod
match path1=(z:itemlocation)-[m:stored_at]->(dc:location) where dc.locationKey like '%DC-Sysco-Columbus-OH%'
match path2=(z:itemlocation)-[c:consists_of]->(b:itemlocation)
match path3=(b:itemlocation)-[n:makes]->(item:item)
optional match path4=(b)-[p:stored_at]->(q:location)
return to_json(path1) as path1, to_json(path2) as path2,to_json(path3) as path3, to_json(path4) as path4
خروجی: 
۹. مورد استفاده ۳: فراخوانی پاییندستی
سناریو: تأمینکنندهای به شما اطلاع میدهد که دسته خاصی از محصولات آلوده است: گوجهفرنگیهای رسیده روی بوته از تأمینکننده. باید همه گزینههای منو نهایی تحتتأثیرقرارگرفته را در کافهها پیدا کنید.
پُرسمان پیمایش
مکان مواد خام آلوده را جستجو میکنید، سپس پیمایش مسیر را در جهت جریان پاییندست انجام میدهید تا موارد نهایی تحتتأثیر قرارگرفته را پیدا کنید.
%%bigquery  --project=$PROJECT_ID --graph
Graph restaurant.bombod
match path1=(a:itemlocation)-[c:consists_of]->(b:itemlocation)-[e:makes]->(f:item) where f.itemKey like '%Tomato%'
return to_json(path1) as result
این پُرسمان همه مواردی را که با الگوی «گوجهفرنگی» مطابقت دارند و با رابطه بالادستی درهمتنیده شدهاند پیدا میکند و این امر آن را به نگاشتی قدرتمند تبدیل میکند که برای کشف اینکه کدام موارد کافه باید فراخوانده شوند منتشر میشود.
خروجی: 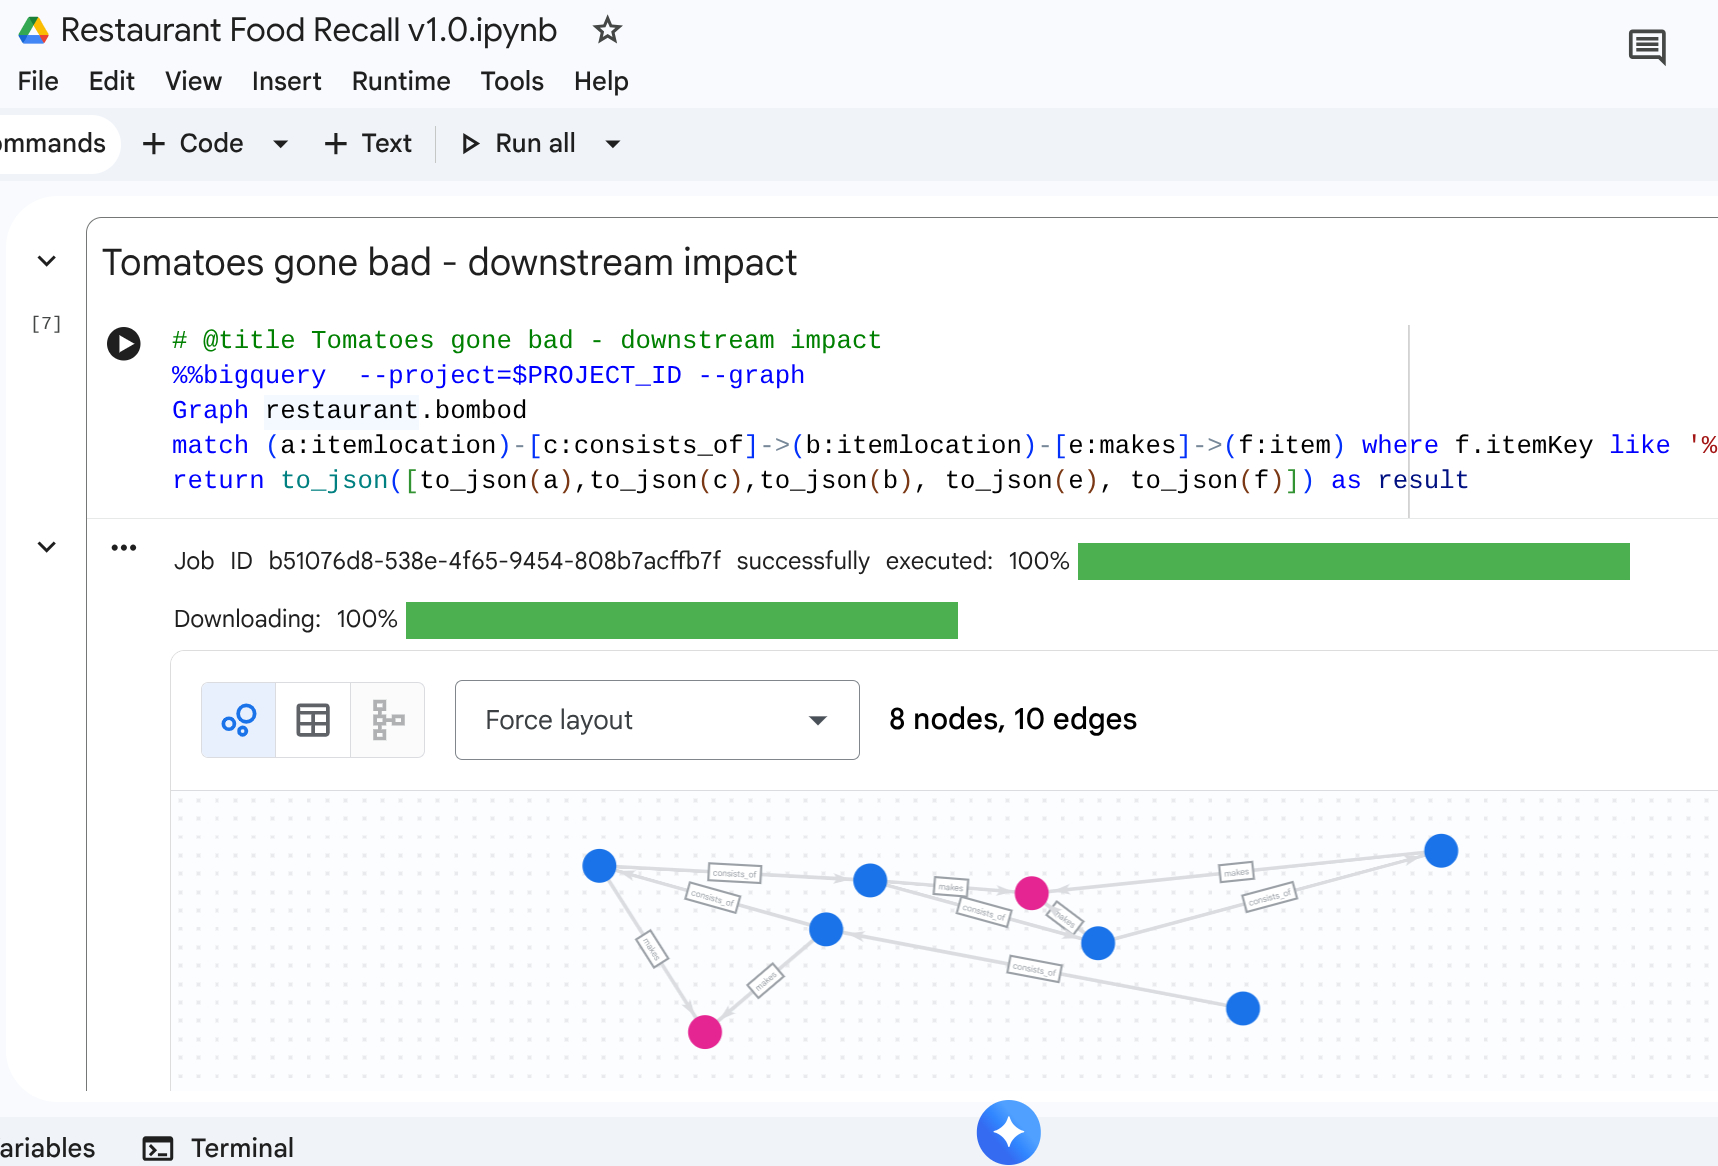
۱۰. پاکسازی کردن
پساز تکمیل مراحل راهنمای گامبهگام، منابع را حذف کنید تا از هرگونه هزینه باقیمانده در فضای کاریتان جلوگیری شود.
DROP SCHEMA `restaurant` CASCADE;
۱۱. نتیجهگیری
تبریک! شما یک زنجیره تأمین را مدلسازی کردهاید و تجزیهوتحلیل تأثیر را بااستفاده از BigQuery Graph اجرا کردهاید.
جمعبندی کردن
با این موارد آشنا شدید:
- روابط نسبی گرافمحور را با کلیدهای اصلی/خارجی اعلام کنید.
- نمودار دارایی یکپارچه ایجاد کنید.
- بااستفاده از منطق پیمایش «پُرسمان گراف»، روابط چندگرهای را بهطور مؤثر پیمایش کنید.
برای کسب اطلاعات آماری بیشتر درباره معماری گراف، به اسناد Google Cloud مراجعه کنید.