
1. Введение
В этой практической работе вы создадите модульную комплексную систему разрешения идентификаторов клиентов (сопоставления объектов) прямо в Google Cloud BigQuery. Вы будете использовать Google Cloud Shell для развертывания инфраструктуры и редактор SQL в BigQuery Studio для очистки данных, оценки кандидатов, построения графа свойств и обхода путей ISO GQL (Graph Query Language).
Идентификация – это базовая функция для корпоративного решения Customer 360, обнаружения мошенничества и консолидации данных из нескольких систем. Поскольку существует множество допустимых подходов к идентификации в зависимости от зрелости данных и потребностей бизнеса, все шаги в этой практической работе являются модульными и необязательными. Конвейер разработан для демонстрации различных распространенных отраслевых методов промышленного уровня, включая нормализацию адресов с помощью удаленных UDF, фонетическую блокировку Soundex, семантический векторный поиск (AI.EMBED), гибридную оценку признаков и кластеризацию графов свойств GQL, чтобы вы могли выборочно применять шаблоны, соответствующие вашей архитектуре.
Методы сопоставления и пороговые значения оценки следует настраивать в зависимости от того, какой тип сопоставления предпочитает ваша организация – детерминированный или вероятностный. Это зависит от целевого варианта использования. Например, для строгого соблюдения требований, выставления счетов или финансовых операций обычно предпочитают высокоточные детерминированные правила (такие как точные совпадения SSN или идентификационного номера налогоплательщика), чтобы предотвратить ложную привязку, тогда как персонализация маркетинга, аналитика и системы рекомендаций часто опираются на вероятностное нечеткое сопоставление и семантическое векторное сходство, чтобы максимизировать полноту и выявить тонкие связи.

Что вам предстоит сделать
- Загрузка набора данных FEBRL3 Benchmark. Загрузите синтетические записи клиентов и пары совпадений фундаментальной истины в BigQuery.
- Развертывание удаленной пользовательской функции Address Validation. Разверните функцию Cloud Functions на Python и зарегистрируйте удаленную функцию BigQuery, чтобы нормализовать почтовые адреса.
- Предварительная обработка данных профиля и фонетических кодировок. Выполните очистку данных SQL, вызовите UDF адреса и вычислите фонетические ключи
SOUNDEXи расстояния редактирования Левенштейна:- Фонетическое кодирование Soundex. Фонетический алгоритм для индексирования имен по звучанию на английском языке. Он преобразует имена в четырехзначный код (первая буква и три цифры), представляющий группы согласных звуков (например,
"John"и"Jon"сопоставляются сJ500, а"Smith"и"Smyth"– сS530). Это позволяет получать сигналы фонетического соответствия для оценки функций и блокировки дельты в реальном времени. - Расстояние Левенштейна (
EDIT_DISTANCE). Строковый показатель, который измеряет минимальное количество правок отдельных символов (вставок, удалений или замен), необходимых для изменения одной строки на другую. Это позволяет точно сопоставлять нечеткие имена и адреса.
- Фонетическое кодирование Soundex. Фонетический алгоритм для индексирования имен по звучанию на английском языке. Он преобразует имена в четырехзначный код (первая буква и три цифры), представляющий группы согласных звуков (например,
- Генерируйте семантические профили и выполняйте векторный поиск. Генерируйте текстовые эмбеддинги непосредственно в SQL с помощью
AI.EMBED(text-embedding-005) и находите K ближайших соседей с помощьюVECTOR_SEARCH, чтобы использовать их в качестве сублинейного уровня генерации кандидатов. - Оценка пар кандидатов и гибридное слияние признаков ребер. Используйте пары кандидатов векторного поиска, чтобы устранить сложность перекрестного соединения O(N²), вычислить взвешенные оценки сходства по нескольким признакам (SSN, расстояние редактирования Левенштейна, дата рождения, индекс Жаккара для адреса) и объединить ребра в единую таблицу кандидатов.
- Создание графа свойств и обход путей ISO GQL. Создайте
PROPERTY GRAPHBigQuery, выполните запросы путей ISO GQL{1, 2}(GRAPH_TABLE), чтобы определить связанные кластеры клиентов, рассчитайте отдельные показатели оценки и выполните мягкую кластеризацию домохозяйств с помощью взвешивания графа Адамика – Адара. - Инкрементальное разрешение и постоянная стабильность. Обрабатывайте ежедневные пакеты данных с инкрементальным сопоставлением дельты.
- Консолидация кластеров и стабильность кластеров (перекрытие 1-ε). Обеспечьте стабильность кластеров при выполнении конвейера, используя гарантию порога перекрытия (1-ε).
Что вам понадобится
- Браузер, например Chrome.
- Проект Google Cloud с включенными платежными функциями.
Эта практическая работа предназначена для инженеров данных, разработчиков баз данных и специалистов по ИИ и машинному обучению всех уровней, включая начинающих.
Расчетная продолжительность: 45 минут.
Расчетная стоимость: менее 2 долларов США (используются Cloud Functions с оплатой по мере использования и обработка запросов BigQuery).
2. Подготовка
Как создать проект Google Cloud
- В Google Cloud Console на странице выбора проекта выберите или создайте проект Google Cloud.
- Убедитесь, что для вашего облачного проекта включены платежные функции. Подробнее о том, как проверить, включены ли платежные функции для проекта…
Запустить Cloud Shell
Cloud Shell – это среда командной строки, работающая в Google Cloud, в которой предварительно загружены необходимые инструменты.
- В верхней части консоли Google Cloud нажмите Activate Cloud Shell (Активировать Cloud Shell).
- Проверьте аутентификацию:
gcloud auth list
- Настройте переменные среды в Cloud Shell:
export GCP_PROJECT=$(gcloud config get-value project)
export REGION="us-central1"
export DATASET_ID="identity_resolution"
Включите необходимые API
Чтобы включить все необходимые сервисы Google Cloud, выполните в Cloud Shell следующую команду, используя свой аккаунт пользователя:
gcloud services enable \
  addressvalidation.googleapis.com \
  cloudbuild.googleapis.com \
  cloudfunctions.googleapis.com \
  cloudresourcemanager.googleapis.com \
  artifactregistry.googleapis.com \
  aiplatform.googleapis.com \
  run.googleapis.com \
  bigqueryconnection.googleapis.com \
  bigqueryreservation.googleapis.com \
  bigquery.googleapis.com
Настройка сервисного аккаунта и олицетворения (рекомендуется)
Чтобы обеспечить бесперебойное выполнение API и доступ к Application Default Credentials (ADC), создайте специальный сервисный аккаунт и включите олицетворение gcloud:
# 1. Create a Service Account for the lab (if it does not already exist)
gcloud iam service-accounts create identity-res-sa \
  --display-name="Identity Resolution Service Account" 2>/dev/null || true

# Wait 5 seconds for IAM propagation
sleep 5

# Extract Project Number for default build and compute service accounts
export PROJECT_NUMBER=$(gcloud projects describe ${GCP_PROJECT} --format="value(projectNumber)")

# 2. Grant specific required least-privilege roles to the lab Service Account
for role in roles/bigquery.admin \
            roles/bigquery.resourceAdmin \
            roles/run.admin \
            roles/cloudfunctions.admin \
            roles/resourcemanager.projectIamAdmin \
            roles/cloudbuild.builds.editor \
            roles/cloudbuild.builds.builder \
            roles/artifactregistry.repoAdmin \
            roles/artifactregistry.writer \
            roles/storage.admin \
            roles/logging.logWriter \
            roles/iam.serviceAccountUser \
            roles/aiplatform.user; do
  gcloud projects add-iam-policy-binding ${GCP_PROJECT} \
    --member="serviceAccount:identity-res-sa@${GCP_PROJECT}.iam.gserviceaccount.com" \
    --role="${role}" --quiet
done

# 3. Grant required build & storage permissions to default Compute Engine & Cloud Build service accounts (required for 2nd-gen Cloud Functions container builds)
for role in roles/cloudbuild.builds.builder \
            roles/logging.logWriter \
            roles/artifactregistry.writer \
            roles/storage.objectAdmin; do
  gcloud projects add-iam-policy-binding ${GCP_PROJECT} \
    --member="serviceAccount:${PROJECT_NUMBER}-compute@developer.gserviceaccount.com" \
    --role="${role}" --quiet || true
  gcloud projects add-iam-policy-binding ${GCP_PROJECT} \
    --member="serviceAccount:${PROJECT_NUMBER}@cloudbuild.gserviceaccount.com" \
    --role="${role}" --quiet || true
done

# 4. Grant Service Account Token Creator role to your user account
export SA_EMAIL="identity-res-sa@${GCP_PROJECT}.iam.gserviceaccount.com"

gcloud iam service-accounts add-iam-policy-binding \
  "${SA_EMAIL}" \
  --member="user:$(gcloud config get-value account)" \
  --role="roles/iam.serviceAccountTokenCreator" --quiet

# 5. Enable Service Account impersonation for gcloud
gcloud config set auth/impersonate_service_account "${SA_EMAIL}"

# 6. Wait for IAM role assignments and impersonation caches to propagate
echo "Waiting 90 seconds for IAM policies and impersonation caches to propagate..."
sleep 90
Создать набор данных BigQuery
Создайте набор данных BigQuery для хранения узлов, ребер, моделей графов и представлений оценки клиентов.
bq mk --location=US --dataset ${GCP_PROJECT}:${DATASET_ID}
Вы должны увидеть примерно следующее:
Dataset 'your-project-id:identity_resolution' successfully created.
Создать резервирование и назначение BigQuery
Чтобы выполнять GQL-запросы, у вас должна быть резервация, в которой используется версия Enterprise или Enterprise Plus. Создайте резервацию Enterprise Edition с автомасштабированием в Cloud Shell:
# 1. Create a BigQuery Enterprise reservation with 0 baseline slots and 100 max autoscaling slots
bq mk --reservation \
  --project_id=${GCP_PROJECT} \
  --location=US \
  --edition=ENTERPRISE \
  --slots=0 \
  --autoscale_max_slots=100 \
  --ignore_idle_slots=true \
  identity-res-reservation

# 2. Assign your Cloud project to the newly created reservation for query execution
bq mk --reservation_assignment \
  --project_id=${GCP_PROJECT} \
  --location=US \
  --reservation_id=identity-res-reservation \
  --job_type=QUERY \
  --assignee_type=PROJECT \
  --assignee_id=${GCP_PROJECT}
3. Импорт набора данных Customer Node из FEBRL3
Прежде чем развертывать удаленную функцию Address Validation и выполнять сопоставление идентификационной информации, вы загрузите синтетический набор данных FEBRL3 для тестирования сопоставления объектов (содержит 5000 записей клиентов с кластерами, в которых может быть до пяти дубликатов на клиента), используя библиотеку Python recordlinkage, и запишете необработанные узлы клиентов (customer_nodes) и ссылки на совпадения фундаментальной истины (ground_truth_links) в BigQuery с помощью BigQuery DataFrames (bigframes).
Чтобы установить зависимости и запустить скрипт передачи данных, выполните в Cloud Shell следующие команды:
# 1. Install recordlinkage dataset library & bigframes (if outside Cloud Shell, activate your virtual environment first)
pip install recordlinkage bigframes --quiet

# 2. Write and execute the FEBRL3 dataset ingestion script
cat << 'E>OF'  ingest_febrl.py
import os
import pandas as pd
import bigframes.pandas as bpd
from recordlinkage.datasets import load_febrl3

GCP_PROJECT = os.environ.get("GCP_PROJECT", "your-project-id")
DATASET_ID = "identity_resolution"

table_raw_id = f"{GCP_PROJECT}.{DATASET_ID}.customer_nodes"
table_gt_id = f"{GCP_PROJECT}.{DATASET_ID}.ground_truth_links"

print("Loading FEBRL3 benchmark dataset...")
df_nodes, true_links = load_febrl3(return_links=True)
df_nodes = df_nodes.reset_index()
df_nodes['dataset_source'] = 'febrl3'

for col in df_nodes.columns:
    if df_nodes[col].dtype == 'object':
        df_nodes[col] = df_nodes[col].fillna('')

print("Ingesting raw customer nodes into BigQuery via BigQuery DataFrames...")
bf_nodes = bpd.read_pandas(df_nodes)
bf_nodes.to_gbq(table_raw_id, if_exists="replace")

print("Ingesting ground truth links into BigQuery via BigQuery DataFrames...")
df_gt = pd.DataFrame(list(true_links), columns=["source_id", "target_id"])
bf_gt = bpd.read_pandas(df_gt)
bf_gt.to_gbq(table_gt_id, if_exists="replace")

print(f"Raw customer nodes ingested into `{table_raw_id}` ({len(df_nodes):,} rows).")
print(f"Ground truth links ingested into `{table_gt_id}` ({len(df_gt):,} pairs).")
EOF

python3 ingest_febrl.py
В консоли Google Cloud перейдите в BigQuery Studio, откройте новую вкладку SQL-запрос (+) и выполните приведенный ниже запрос, чтобы проверить импортированную таблицу узлов клиентов.
SELECT rec_id, given_name, surname, street_number, address_1, address_2, suburb, postcode, state, date_of_birth, soc_sec_id, dataset_source
FROM `identity_resolution.customer_nodes`
LIMIT 5;
Вы должны увидеть примерно следующее:
rec_id | given_name | – | street_number | address_1 | address_2 | пригород | почтовый индекс | штат | date_of_birth | soc_sec_id | dataset_source |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| |
|
|
|
|
|
|
|
|
|
|
| |
|
|
|
|
|
|
|
|
|
| ||
|
|
|
|
|
|
|
|
|
|
|
|
Обратите внимание, как контрольный набор данных вводит реалистичные грязные данные в кластеры дубликатов:
- Фонетические и орфографические варианты:
brentиbrnt/bernt,woodиwoode/wod,cliftonиcliffton. - Сокращения и опечатки в адресе. Например,
girdlestone circuitвместоgirdelstone circut,girdlestone cirилиgirdlestone crt, а также номер дома11вместо ошибки оптического распознавания символов15. - Перестановка символов и отсутствующие значения. Перестановка символов в дате рождения (
19340706вместо19340760), отсутствие штата ( ) и отсутствие номера социального страхования ( ).
На следующих шагах вы будете использовать фонетические кодировки SOUNDEX, UDF для нормализации адресов, расстояние редактирования Левенштейна и векторный поиск AI.EMBED, чтобы устранить эти расхождения и точно связать дублирующиеся профили.
4. Развертывание UDF удаленной функции Address Validation
Нормализация адресов стандартизирует названия улиц, границы пригородов и почтовые индексы перед сопоставлением. Google Maps Address Validation API – это сервис, который принимает адрес, определяет его компоненты и проверяет их. На этом шаге вы развернете функцию Python Cloud Functions в Cloud Shell, которая предоставляет BigQuery пользовательскую функцию (UDF) для Address Validation и нормализации адресов.
Как создать исходные файлы функции Cloud Functions
Чтобы создать каталог с исходными файлами функции Cloud Functions и записать main.py и requirements.txt, выполните в Cloud Shell следующую команду:
mkdir -p cloud_function_address_validation && cd cloud_function_address_validation

cat << 'E>OF'  main.py
import os
import json
import logging
import requests
from functools import lru_cache
from concurrent.futures import ThreadPoolExecutor

import functions_framework
import google.auth
from google.auth.transport.requests import AuthorizedSession
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

ADDRESS_VALIDATION_URL = "https://addressvalidation.googleapis.com/v1:validateAddress"
ENABLE_ADDRESS_VALIDATION_API = os.environ.get("ENABLE_ADDRESS_VALIDATION_API", "false").lower() == "true"

# ==========================================
# GLOBAL INITIALIZATION (Runs once per Cold Start)
# ==========================================

credentials, _ = google.auth.default(scopes=["https://www.googleapis.com/auth/cloud-platform"])
session = AuthorizedSession(credentials)

retries = Retry(
    total=4,
    backoff_factor=0.5,
    status_forcelist=[429, 500, 502, 503, 504],
    allowed_methods=["POST"]
)
adapter = HTTPAdapter(max_retries=retries, pool_connections=100, pool_maxsize=100)
session.mount("https://", adapter)

executor = ThreadPoolExecutor(max_worker>s=50)


@lru_cache(maxsize=10000)
def call_validation_api(address_text: str) - str:
    payload = {
        "address": {
            "regionCode": "AU",
            "addressLines": [address_text]
        }
    }

    response = session.post(ADDRESS_VALIDATION_URL, json=payload, timeout=10)
    response.raise_for_status()

    res_data = response.json()
    result = res_data.get('result', {})
    address_obj = result.get('address', {})
    verdict = result.get('verdict', {})

    formatted = address_obj.get('formattedAddress', address_text).lower()
    has_unconfirmed = verdict.get('hasUnconfirmedComponents', True)
    address_complete = verdict.get('addressComplete', False)
    granularity = verdict.get('validationGranularity', 'UNCONFIRMED')
    actions = verdict.get('possibleNextActions', [])
    next_action = str(actions[0]) if actions else "NONE"

    is_valid = bool(address_complete and not has_unconfirmed)

    return {
        "formatted_address": formatted,
        "address_is_valid": is_valid,
        "validation_granularity": granularity,
        "possible_next_action": next_action
    }


def process_single_call(call):
    call = call or []
    padded = (call + [""] * 6)[:6]

    cleaned_parts = [str(p).strip() if p is not None else "" for p in padded]
    street_num, addr_1, addr_2, suburb, state, postcode = cleaned_parts

    address_parts = [p for p in cleaned_parts if p]
    address_text = " ".join(address_parts)

    if not address_text:
        return {
            "formatted_address": "",
            "address_is_valid": False,
            "validation_granularity": "EMPTY",
            "possible_next_action": "NONE"
        }

    if not ENABLE_ADDRESS_VALIDATION_API:
        normalized = (
      >      address_text.lower()
            .replace("street", "st")
            .replace("road", "rd")
            .replace("place", "pl")
            .replace("avenue", "ave")
            .replace("circuit", "cct")
        )
        return {
            "formatted_address": normalized,
            "address_is_valid": bool(len(address_parts) = 3),
            "validation_granularity": "PREMISE" if postcode and suburb else "SUBURB",
            "possible_next_action": "NONE"
        }

    try:
        return call_validation_api(address_text)
    except Exception as e:
        logging.error(f"Address Validation API Error for '{address_text}': {str(e)}")
        return {
            "formatted_address": address_text.lower(),
            "address_is_valid": False,
            "validation_granularity": "UNCONFIRMED",
            "possible_next_act<<ion&quo>t;: "NONE"
        }


@functions_framework.http
def validate_address_udf(request):
    request_json = request.get_json(silent=True) or {}
    calls = request_json.get('calls', [])

    if not calls:
        return {'replies': []}

    try:
        # executor.map inherently preserves array input order (Strictly required by BigQuery)
        replies = list(executor.map(process_single_call, calls))
        return {'replies': replies}
    except Exception as e:
        logging.error(f"Batch execution failed: {e}")
        return {'errorMessage': str(e)}, 400
EOF

cat  'EOF'  requirements.txt
functions-framework==3.*
requests==2.*
google-auth==2.*
urllib3==2.*
EOF
Развертывание функции Cloud Functions и настройка разрешений IAM
Чтобы развернуть функцию Cloud Functions второго поколения и настроить подключение к ресурсу Google Cloud в BigQuery, выполните в Cloud Shell следующие команды:
# 1. Deploy 2nd-Gen Cloud Function
gcloud functions deploy validate_address_udf \
  --gen2 \
  --runtime=python311 \
  --region=${REGION} \
  --source=. \
  --entry-point=validate_address_udf \
  --trigger-http \
  --no-allow-unauthenticated \
  --memory=512Mi \
  --cpu=1 \
  --concurrency=80 \
  --quiet

# 2. Extract Function Endpoint URI
export FUNCTION_URL=$(gcloud functions describe validate_address_udf --region=${REGION} --gen2 --format="value(serviceConfig.uri)")

# 3. Create BigQuery Cloud Resource Connection
bq mk --connection --location=US --project_id=${GCP_PROJECT} --connection_type=CLOUD_RESOURCE address_val_conn || true

# 4. Extract Connection Service Account Email
export BQ_SA_EMAIL=$(bq show --format=prettyjson --connection US.address_val_conn | grep -o '"serviceAccountId": "[^"]*"' | cut -d'"' -f4)

# 5. Bind Cloud Run Invoker and Vertex AI User IAM Roles to BigQuery Connection Service Account
gcloud run services add-iam-policy-binding validate-address-udf \
  --region=${REGION} \
  --member="serviceAccount:${BQ_SA_EMAIL}" \
  --role="roles/run.invoker" --quiet

gcloud projects add-iam-policy-binding ${GCP_PROJECT} \
  --member="serviceAccount:${BQ_SA_EMAIL}" \
  --role="roles/aiplatform.user" --quiet

# 6. Wait for connection IAM policy propagation
echo "Waiting 60 seconds for BigQuery connection IAM policy to propagate..."
sleep 60
Вы увидите сообщение о том, что развертывание функции Cloud Functions завершено и привязки IAM успешно применены.
Зарегистрировать функцию нормализации удаленного адреса
Теперь вы зарегистрируете DDL удаленной функции BigQuery (validate_address_udf), которая связывает строки таблицы BigQuery с развернутой конечной точкой Cloud Functions (${FUNCTION_URL}).
Чтобы получить URL развернутой функции Cloud Functions и автоматически зарегистрировать удаленную функцию, выполните в Cloud Shell следующую команду:
# 1. Retrieve deployed Cloud Function URL
export FUNCTION_URL=$(gcloud functions describe validate_address_udf --region=${REGION:-us-central1} --gen2 --format="value(serviceConfig.uri)")

# 2. Register Remote Function DDL in BigQuery
bq query --use_legacy_sql=false \
"CREATE OR REPLACE FUNCTION \`${GCP_PROJECT}.${DATASET_ID}.validate_address_udf\`(
  street_number STRING,
  address_1 STRING,
  address_2 STRING,
  suburb STRING,
  state STRING,
  postcode STRING
) RETURNS JSON
REMOTE WITH CONNECTION \`us.address_val_conn\`
OPTIONS (
  endpoint = '${FUNCTION_URL}',
  max_batching_rows = 100
);"
5. Предварительная обработка данных профиля и фонетических кодировок
На этом шаге вы выполните SQL-запрос предварительной обработки BigQuery для импортированной таблицы customer_nodes.
Выполнить очистку данных и запрос фонетических функций
В редакторе SQL BigQuery Studio выполните запрос ниже, чтобы создать customer_nodes_cleaned. Этот запрос:
- Вызывает
validate_address_udf, чтобы получить нормализованные адреса и результаты проверки. - Генерирует фонетические кодировки
SOUNDEXдляgiven_nameиsurname, чтобы обрабатывать варианты написания. - Создает структурированное поле
profile_text.
CREATE OR REPLACE TABLE `identity_resolution.customer_nodes_cleaned` AS
WITH raw_data AS (
  SELECT
    rec_id, dataset_source,
    TRIM(LOWER(given_name)) AS given_name_clean,
    TRIM(LOWER(surname)) AS surname_clean,
    `identity_resolution.validate_address_udf`(street_number, address_1, address_2, suburb, state, postcode) AS addr_json,
    TRIM(suburb) AS suburb, TRIM(state) AS state, TRIM(postcode) AS postcode,
    TRIM(date_of_birth) AS date_of_birth, TRIM(soc_sec_id) AS soc_sec_id
  FROM `identity_resolution.customer_nodes`
)
SELECT
  rec_id, dataset_source,
  given_name_clean AS given_name,
  SOUNDEX(given_name_clean) AS given_name_soundex,
  surname_clean AS surname,
  SOUNDEX(surname_clean) AS surname_soundex,
  CONCAT(given_name_clean, ' ', surname_clean) AS full_name,
  STRING(addr_json.formatted_address) AS formatted_address,
  BOOL(addr_json.address_is_valid) AS address_is_valid,
  STRING(addr_json.validation_granularity) AS validation_granularity,
  STRING(addr_json.possible_next_action) AS possible_next_action,
  suburb, state, postcode, date_of_birth, soc_sec_id,
  CONCAT('Name: ', CONCAT(given_name_clean, ' ', surname_clean), '; Address: ', STRING(addr_json.formatted_address), '; DOB: ', date_of_birth, '; SSN: ', soc_sec_id) AS profile_text
FROM raw_data;
Запросите таблицу очищенных узлов:
SELECT rec_id, given_name, given_name_soundex, surname, surname_soundex, formatted_address
FROM `identity_resolution.customer_nodes_cleaned`
LIMIT 5;
Вы должны увидеть примерно следующее:
rec_id | given_name | given_name_soundex | – | surname_soundex | formatted_address |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
6. Создание векторных представлений семантических профилей и векторный поиск
Помимо нормализации адресов, фонетических ключей Soundex и расстояния Левенштейна, BigQuery поддерживает встроенные функции встраивания генеративного искусственного интеллекта через AI.EMBED.
С помощью AI.EMBED BigQuery генерирует текстовые эмбеддинги непосредственно в SQL, используя базовые модели (например, text-embedding-005):
Генерирование эмбеддингов профилей и выполнение векторного поиска Top-K
Выполните приведенные ниже запросы в редакторе SQL BigQuery Studio.
-- 1. Generate Customer Profile Embeddings using AI.EMBED (offloaded to Vertex AI)
CREATE OR REPLACE TABLE `identity_resolution.customer_embeddings` AS
SELECT
  rec_id,
  dataset_source,
  profile_text,
  AI.EMBED(profile_text, connection_id => 'us.address_val_conn', en>dpoint = 'text-embedding-005').result AS text_embedding
FROM `identity_resolution.customer_nodes_cleaned`;

-- 2. Execute VECTOR_SEARCH for Top-K Nearest Neighbors Candidate Generation
CREATE OR REPLACE TABLE `identity_resolution.vector_candidate_edges` AS
SELECT DISTINCT
  LEAST(query.rec_id, base.rec_id) AS source_id,
  GREATEST(query.rec_id, base.rec_id) AS target_id,
  distance AS vector_distance
FROM VECTOR_SEARCH(
  TABLE `identity_resolution.customer_embeddings`,
  'text_embedding',
  TABLE `identity_resolution.custome>r_embeddings`,
  top_k> = 10,
  distance_type = 'COSINE'
)
WHERE query.rec<_id != base.rec_id AND distance = 0.25;
7. Оценка пар кандидатов и гибридное объединение функций Edge
Оценка всех возможных пар записей клиентов (квадратичный рост O(N²)) становится невозможной с точки зрения вычислений по мере роста масштаба набора данных. В реляционных базах данных, таких как BigQuery, попытка реализовать блокировку на основе правил с помощью сложных условий соединения OR по нескольким столбцам (например, соединение по a.soc_sec_id = b.soc_sec_id OR a.given_name_soundex = b.given_name_soundex OR ...) не позволяет оптимизатору запросов использовать масштабируемые хеш-соединения или соединения сортировкой-слиянием по одному ключу эквисоединения. Вместо этого механизм возвращается к перекрестному соединению O(N²) и фильтрует каждую пару, что не работает в масштабе.
На этом этапе вы возьмете пары кандидатов, сгенерированные таблицей векторного поиска (vector_candidate_edges), и объедините их с customer_nodes_cleaned с помощью быстрых индексированных эквисоединений (ON c.source_id = a.rec_id и ON c.target_id = b.rec_id). Затем вы рассчитаете взвешенную оценку соответствия, объединив:
- SSN Match Score (вес:
0.30) - Сходство фамилий с использованием расстояния Левенштейна
EDIT_DISTANCE(вес:0.20) - Сходство имени (вес:
0.20) - Оценка совпадения даты рождения (вес:
0.15) - Коэффициент Жаккара для токенов адреса (вес:
0.15) большеSPLIT(LOWER(formatted_address), ' ').
Вычисление ребер-кандидатов и взвешенных показателей сходства
Чтобы заполнить таблицу matched_edges, выполните в редакторе SQL BigQuery Studio следующий запрос:
CREATE OR REPLACE TABLE `identity_resolution.matched_edges` AS
WITH candidate_pairs AS (
  SELECT
    c.source_id, c.target_id,
    a.given_name AS a_given_name, b.given_name AS b_given_name,
    a.surname AS a_surname, b.surname AS b_surname,
    a.given_name_soundex AS a_gn_snd, b.given_name_soundex AS b_gn_snd,
    a.surname_soundex AS a_sn_snd, b.surname_soundex AS b_sn_snd,
    a.date_of_birth AS a_dob, b.date_of_birth AS b_dob,
    a.soc_sec_id AS a_ssn, b.soc_sec_id AS b_ssn,
    SPLIT(LOWER(a.formatted_address), ' ') AS a_tokens,
    SPLIT(LOWER(b.formatted_address), ' ') AS b_tokens
  FROM `identity_resolution.vector_candidate_edges` c
  JOIN `identity_resolution.customer_nodes_cleaned` a ON c.source_id = a.rec_id
  JOIN `identity_resolution.customer_nodes_cleaned` b ON c.target_id = b.rec_id
),
scored_pairs AS (
  SELECT
    source_id, target_id,
    CASE WHEN a_ssn = b_ssn AND a_ssn != '' THEN 1.0 ELSE 0.0 END AS ssn_match,
    CASE WHEN a_dob = b_dob THEN 1.0 ELSE 0.0 END AS dob_match,
    CASE WHEN a_gn_snd = b_gn_snd THEN 1.0 ELSE 0.0 END AS given_name_soundex_match,
    CASE WHEN a_sn_snd = b_sn_snd THEN 1.0 ELSE 0.0 END AS surname_soundex_match,
    GREATEST(
      (1.0 - (EDIT_DISTANCE(a_given_name, b_given_name) / GREATEST(LENGTH(a_given_name), LENGTH(b_given_name), 1))),
      (1.0 - (EDIT_DISTANCE(a_given_name, b_surname) / GREATEST(LENGTH(a_given_name), LENGTH(b_surname), 1)))
    ) AS given_name_edit_sim,
    GREATEST(
      (1.0 - (EDIT_DISTANCE(a_surname, b_surname) / GREATEST(LENGTH(a_surname), LENGTH(b_surname), 1))),
      (1.0 - (EDIT_DISTANCE(a_surname, b_given_name) / GREATEST(LENGTH(a_surname), LENGTH(b_given_name), 1)))
    ) AS surname_edit_sim,
    (
      (SELECT COUNT(DISTINCT t) FROM UNNEST(a_tokens) t JOIN UNNEST(b_tokens) t2 ON t = t2)
      /
      GREATEST(1.0, (SELECT COUNT(DISTINCT t) FROM UNNEST(ARRAY_CONCAT(a_tokens, b_tokens)) t))
    ) AS address_jaccard_sim
  FROM candidate_pairs
)
SELECT
  source_id, target_id,
  ROUND((0.30 * ssn_match) + (0.20 * surname_edit_sim) + (0.20 * given_name_edit_sim) + (0.15 * dob_match) + (0.15 * address_jaccard_sim), 4) AS match_score
FROM scored_pairs
WHERE ((0.30 * ssn_match) + (0.20 * surname_edit_sim) + (0.20 * given_name_edit_sim) + (0.15 * dob_match) + (0.15 >* address_jaccard_sim)) = 0.55;
Проверьте совпадения краев:
SELECT source_id, target_id, match_score
FROM `identity_resolution.matched_edges`
ORDER BY match_score DESC;
Вы должны увидеть примерно следующее:
source_id | target_id | match_score |
|
|
|
|
|
|
|
|
|
Объединение ребер, полученных на основе правил и векторного поиска, в единую таблицу
Объедините ребра кандидатов, полученные в результате нечеткого сопоставления на основе правил и семантического векторного поиска, в одну таблицу final_matched_edges без дубликатов:
CREATE OR REPLACE TABLE `identity_resolution.final_matched_edges` AS
SELECT
  source_id,
  target_id,
  MAX(edge_weight) AS edge_weight,
  IF(COUNT(DISTINCT edge_type) > 1, 'HYBRID', MAX(edge_type)) AS edge_type
FROM (
  SELECT source_id, target_id, match_score AS edge_weight, 'RULE_BASED' AS edge_type
  FROM `identity_resolution.matched_edges`
  UNION ALL
  SELECT source_id, target_id, ROUND(1.0 - vector_distance, 4) AS edge_weight, 'VECTOR_SEARCH' AS edge_type
  FROM `identity_resolution.vector_candidate_edges`
<  WHERE vector_distance = 0.08
)
GROUP BY source_id, target_id;
8. Создание графа свойств и обход путей ISO GQL
BigQuery поддерживает ISO GQL (Graph Query Language) через графы свойств. Граф свойств создает логическое представление графа над реляционными таблицами BigQuery без дублирования данных.
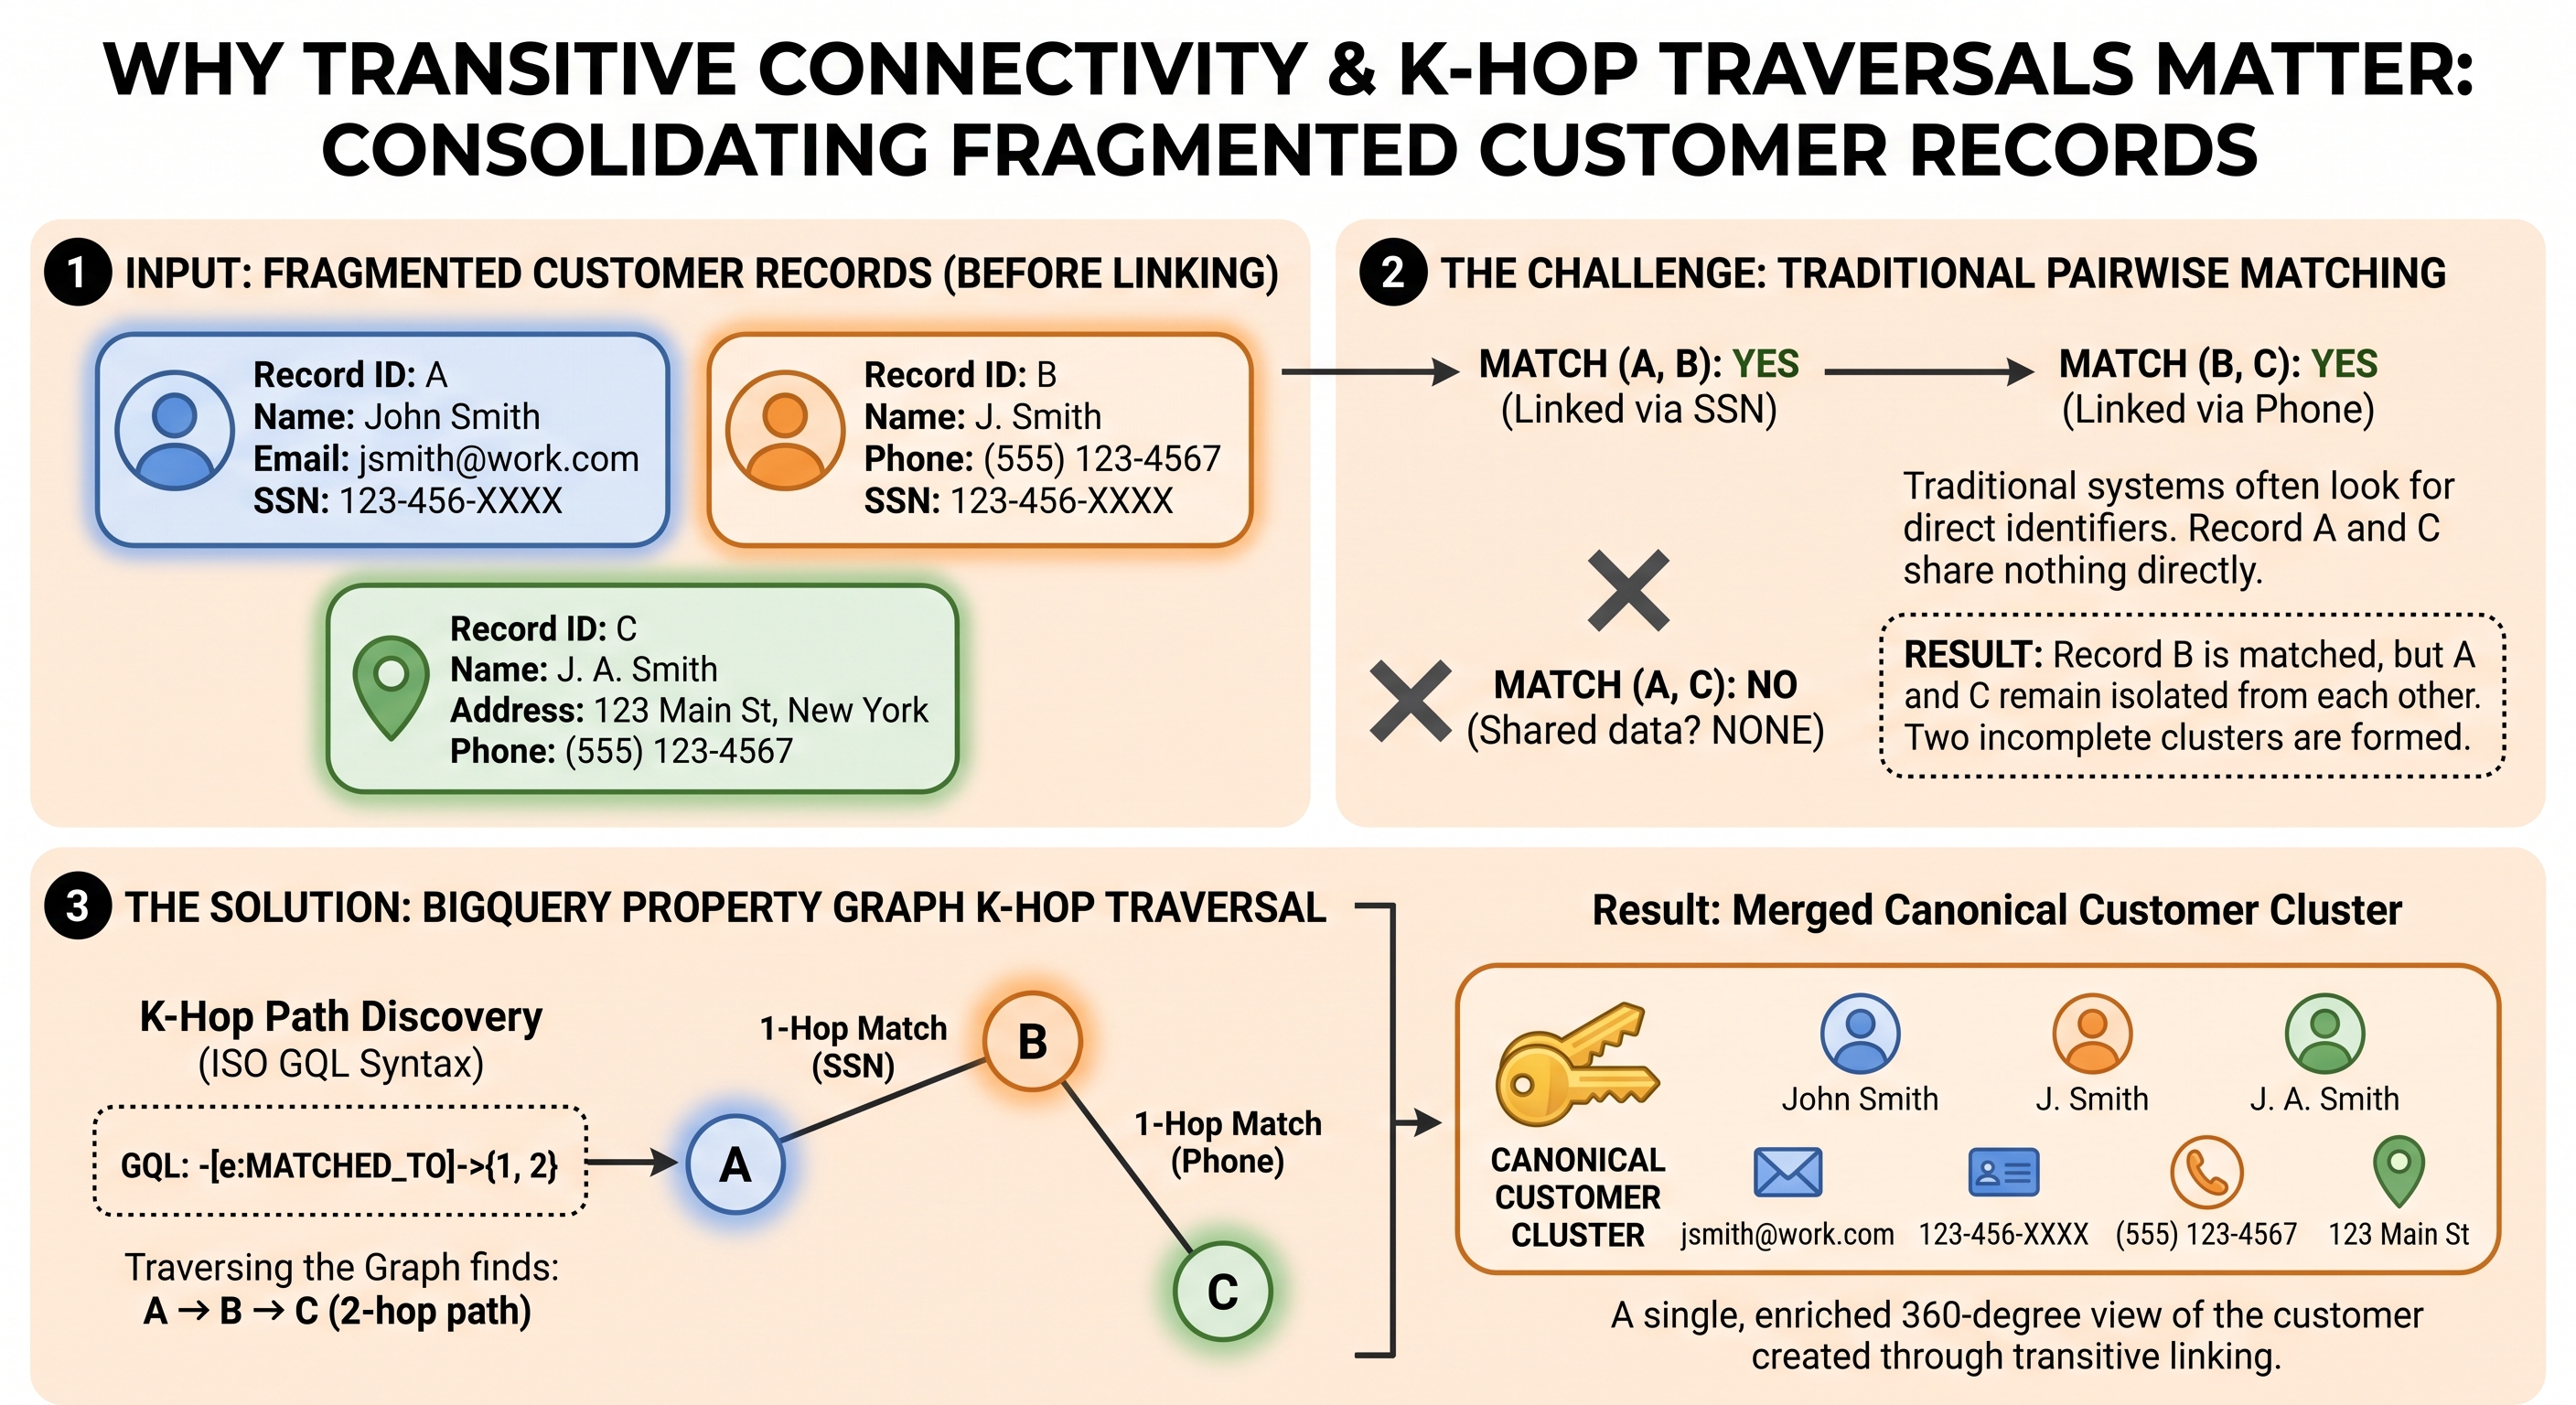
На этом шаге вы создадите граф свойств customer_identity_graph, используя объединенную таблицу ребер кандидатов (final_matched_edges), и запросите связи графа в профилях клиентов, используя обход пути k-hop {1, 2}.
Создать DDL графа свойств BigQuery
Выполните следующую инструкцию DDL в редакторе SQL BigQuery Studio:
CREATE OR REPLACE PROPERTY GRAPH `identity_resolution.customer_identity_graph`
NODE TABLES (
  `identity_resolution.customer_nodes_cleaned` AS `Customer`
  KEY (rec_id)
)
EDGE TABLES (
  `identity_resolution.final_matched_edges`
  KEY (source_id, target_id)
  SOURCE KEY (source_id) REFERENCES `Customer`(rec_id)
  DESTINATION KEY (target_id) REFERENCES `Customer`(rec_id)
  LABEL MATCHED_TO
);
Визуализация кластеров графа K-Hop
Выполните приведенный ниже запрос, чтобы визуализировать совпадающие кластеры клиентов в пределах одного или двух переходов между связями.
GRAPH `identity_resolution.customer_identity_graph`
MATCH p = (c1:Customer)-[e:MATCHED_TO]->{1, 2}(c2:Customer)
RETURN TO_JSON(p) AS graph_cluster_path
LIMIT 10;

Разрешить канонические кластеры клиентов
Выполните следующий запрос, чтобы преобразовать кластеры объектов в resolved_customers:
CREATE OR REPLACE TABLE `identity_resolution.resolved_customers` AS
WITH graph_paths AS (
  SELECT
    source_node_id, target_node_id
  FROM GRAPH_TABLE(
    `identity_resolution.customer_identity_graph`
    MATCH (c1:Customer)-[e:MATCHED_TO]->{1, 2}(c2:Customer)
    COLUMNS (c1.rec_id AS source_node_id, c2.rec_id AS target_node_id)
  )
),
all_connections AS (
  SELECT source_node_id AS node_id, target_node_id AS connected_id FROM graph_paths
  UNION DISTINCT
  SELECT target_node_id AS node_id, source_node_id AS connected_id FROM graph_paths
  UNION DISTINCT
  SELECT rec_id AS node_id, rec_id AS connected_id FROM `identity_resolution.customer_nodes_cleaned`
),
clusters AS (
  SELECT
    node_id,
    MIN(connected_id) AS canonical_customer_id
  FROM all_connections
  GROUP BY node_id
)
SELECT
  canonical_customer_id,
  ARRAY_AGG(node_id) AS customer_records,
  COUNT(node_id) AS record_count
FROM clusters
GROUP BY canonical_customer_id;
Выполните запрос к таблице resolved_clusters:
SELECT canonical_customer_id, record_count, customer_records
FROM `identity_resolution.resolved_customers`
ORDER BY record_count DESC;
Вы должны увидеть примерно следующее:
canonical_customer_id | record_count | customer_records |
|
|
|
|
|
|
|
|
|
Создать представление показателей оценки
Примечание. Оценка на уровне кластера и прямые ребра.
Приведенные ниже показатели позволяют оценить точность сопоставленных объектов клиентов (resolved_customers). Для этого генерируются все пары записей внутри кластера и сравниваются с фундаментальной истиной на уровне отдельных объектов (ground_truth_links). Оценка на уровне кластера позволяет в полной мере использовать преимущества разрешения путей графа ISO GQL (транзитивные многошаговые связи), что дает точное представление о качестве сквозного сопоставления объектов.
Чтобы рассчитать точность, полноту и F1-меру для таблицы ground_truth_links, выполните следующий запрос:
CREATE OR REPLACE VIEW `identity_resolution.evaluation_metrics` AS
WITH predictions AS (
  -- Generate all pairwise record combinations within each resolved canonical customer cluster
  SELECT
    r1 AS source_id,
    r2 AS target_id
  FROM `identity_resolution.resolved_customers`,
  UNNEST(customer_records) AS r1,
  UNNEST(customer_records) AS r2
  WHERE r1 < r2
),
ground_truth AS (
  SELECT
    LEAST(source_id, target_id) AS source_id,
    GREATEST(source_id, target_id) AS target_id
  FROM `identity_resolution.ground_truth_links`
),
stats AS (
  SELECT
    COUNT(g.source_id) AS total_ground_truth,
    COUNT(p.source_id) AS total_predictions,
    COUNTIF(p.source_id IS NOT NULL AND g.source_id IS NOT NULL) AS true_positives,
    COUNTIF(p.source_id IS NOT NULL AND g.source_id IS NULL) AS false_positives,
    COUNTIF(p.source_id IS NULL AND g.source_id IS NOT NULL) AS false_negatives
  FROM ground_truth g
  FULL OUTER JOIN predictions p ON g.source_id = p.source_id AND g.target_id = p.target_id
)
SELECT
  total_ground_truth, total_predictions, true_positives, false_positives, false_negatives,
  ROUND(true_positives / NULLIF(true_positives + false_positives, 0), 4) AS precision,
  ROUND(true_positives / NULLIF(true_positives + false_negatives, 0), 4) AS recall,
  ROUND(2 * true_positives / NULLIF((2 * true_positives) + false_positives + false_negatives, 0), 4) AS f1_score
FROM stats;
Запросите представление показателей оценки:
SELECT * FROM `identity_resolution.evaluation_metrics`;
Вы должны увидеть примерно следующее:
total_ground_truth | total_predictions | true_positives | false_positives | false_negatives | precision | запоминаемость | f1_score |
|
|
|
|
|
|
|
|
Разрешение кластеров домохозяйств с помощью взвешивания графов Адамика-Адара
В то время как идентификация отдельных лиц разрешает записи, принадлежащие одному и тому же человеку, корпоративные архитектуры Customer 360 часто требуют более высокого уровня группировки Household Entity для совместно проживающих лиц, имеющих общий адрес.
Поскольку синтетические тесты (например, FEBRL3) оценивают фундаментальную истину на уровне отдельных лиц, разрешение домохозяйств выполняется как последующий шаг. Если у нас нет истории переездов с временными метками, то пользователи, связанные с несколькими адресами, могут привести к чрезмерному объединению или фрагментации кластеров. Чтобы решить эту проблему, мы используем взвешивание графов Адамика – Адара для создания мягких связей между домохозяйствами.
Выполните приведенный ниже запрос в редакторе SQL BigQuery Studio, чтобы заполнить таблицу household_clusters с помощью взвешивания графа Адамика – Адара.
CREATE OR REPLACE TABLE `identity_resolution.household_clusters` AS
WITH customer_addresses AS (
  SELECT DISTINCT
    r.canonical_customer_id,
    c.formatted_address
  FROM `identity_resolution.resolved_customers` r,
  UNNEST(r.customer_records) AS rec_id
  JOIN `identity_resolution.customer_nodes_cleaned` c ON rec_id = c.rec_id
  WHERE c.formatted_address IS NOT NULL AND c.formatted_address != ''
),
-- Adamic-Adar Exclusivity Weighting: 1.0 / LN(GREATEST(degree, 2))
address_degrees AS (
  SELECT
    formatted_address,
    COUNT(DISTINCT canonical_customer_id) AS address_degree,
    1.0 / LN(GREATEST(COUNT(DISTINCT canonical_customer_id), 2)) AS address_exclusivity_weight
  FROM customer_addresses
  GROUP BY formatted_address
),
customer_household_affinity AS (
  SELECT
    ca.canonical_customer_id,
    ca.formatted_address AS household_address,
    ad.address_degree,
    ad.address_exclusivity_weight AS raw_household_affinity
  FROM customer_addresses ca
  JOIN address_degrees ad ON ca.formatted_address = ad.formatted_address
),
ranked_households AS (
  SELECT
    canonical_customer_id,
    household_address,
    address_degree AS total_residents,
    ROUND(
      COALESCE(SAFE_DIVIDE(raw_household_affinity, SUM(raw_household_affinity) OVER(PARTITION BY canonical_customer_id)), 1.0),
      4
    ) AS household_membership_weight,
    ROW_NUMBER() OVER(PARTITION BY canonical_customer_id ORDER BY raw_household_affinity DESC) AS household_rank
  FROM customer_household_affinity
)
SELECT
  CONCAT('hh-', ABS(FARM_FINGERPRINT(household_address))) AS canonical_household_id,
  canonical_customer_id,
  household_address,
  total_residents,
  household_membership_weight,
  household_rank
FROM ranked_households;
Запрос к таблице сопоставленных кластеров домохозяйств:
SELECT canonical_household_id, canonical_customer_id, household_address, total_residents, household_membership_weight, household_rank
FROM `identity_resolution.household_clusters`
ORDER BY total_residents DESC;
Визуализация иерархии идентификаторов End-to-End с помощью GQL
Чтобы визуально отследить полную трехуровневую иерархию идентификации, связывающую некластеризованных необработанных клиентов с разрешенными клиентами и далее с разрешенными домохозяйствами, сначала создайте таблицы узлов и ребер и обновите DDL графа свойств:
-- 1. Create Household Node Table
CREATE OR REPLACE TABLE `identity_resolution.household_nodes` AS
SELECT DISTINCT
  canonical_household_id,
  household_address,
  total_residents
FROM `identity_resolution.household_clusters`;

-- 2. Create Unresolved Record to Resolved Entity Edge Table
CREATE OR REPLACE TABLE `identity_resolution.customer_entity_edges` AS
SELECT DISTINCT
  rec_id,
  canonical_customer_id
FROM `identity_resolution.resolved_customers`,
UNNEST(customer_records) AS rec_id;

-- 3. Create Primary Household Edge Table (Highest Weighted Household Rank = 1)
CREATE OR REPLACE TABLE `identity_resolution.primary_household_edges` AS
SELECT
  canonical_customer_id,
  canonical_household_id,
  household_membership_weight,
  household_rank
FROM `identity_resolution.household_clusters`
WHERE household_rank = 1;

-- 4. Update Unified Property Graph DDL
CREATE OR REPLACE PROPERTY GRAPH `identity_resolution.customer_identity_graph`
NODE TABLES (
  `identity_resolution.customer_nodes_cleaned` AS `RawCustomer`
    KEY (rec_id),
  `identity_resolution.resolved_customers` AS `ResolvedCustomer`
    KEY (canonical_customer_id),
  `identity_resolution.household_nodes` AS `ResolvedHousehold`
    KEY (canonical_household_id)
)
EDGE TABLES (
  `identity_resolution.final_matched_edges`
    KEY (source_id, target_id)
    SOURCE KEY (source_id) REFERENCES `RawCustomer`(rec_id)
    DESTINATION KEY (target_id) REFERENCES `RawCustomer`(rec_id)
    LABEL MATCHED_TO,
  `identity_resolution.customer_entity_edges`
    KEY (rec_id, canonical_customer_id)
    SOURCE KEY (rec_id) REFERENCES `RawCustomer`(rec_id)
    DESTINATION KEY (canonical_customer_id) REFERENCES `ResolvedCustomer`(canonical_customer_id)
    LABEL RESOLVED_TO,
  `identity_resolution.primary_household_edges`
    KEY (canonical_customer_id, canonical_household_id)
    SOURCE KEY (canonical_customer_id) REFERENCES `ResolvedCustomer`(canonical_customer_id)
    DESTINATION KEY (canonical_household_id) REFERENCES `ResolvedHousehold`(canonical_household_id)
    LABEL BELONGS_TO_HOUSEHOLD
);
Выполните трехуровневый запрос GQL в BigQuery Studio, чтобы визуализировать иерархию домохозяйства с несколькими жильцами:
GRAPH `identity_resolution.customer_identity_graph`
MATCH p = (raw:RawCustomer)-[e1:RESOLVED_TO]->(c:ResolvedCustomer)-[e2:BELONGS_TO_HOUSEHOLD]->(h:ResolvedHousehold)
WHERE h.total_residents > 1
RETURN TO_JSON(p) AS multi_resident_household_hierarchy_path
LIMIT 20;
При выполнении этого GQL-запроса в BigQuery Studio создается трехуровневый интерактивный граф, на котором показаны необработанные записи профилей клиентов (RawCustomer), сопоставленные с отдельными каноническими объектами (ResolvedCustomer), которые связаны с общими объектами домохозяйств с несколькими жителями (ResolvedHousehold).

9. Постепенное разрешение и постоянная стабильность
В реальных корпоративных приложениях новые записи о клиентах поступают непрерывно в виде ежедневных или пакетных поступлений в реальном времени. Вместо того чтобы заново выполнять полное разрешение графа для всего набора данных, система сопоставления дельты сравнивает новые записи с существующими базовыми кластерами (resolved_customers).
Для этого используется векторный поиск (VECTOR_SEARCH) в качестве динамической кластеризации. Рассматривая каждую входящую запись как точку запроса, VECTOR_SEARCH извлекает набор из K ближайших соседей из индекса эмбеддингов контрольной группы. Если входящая запись соответствует существующему профилю клиента выше порога сходства, она динамически объединяется с этим кластером и наследует базовый canonical_customer_id (MATCHED_TO_EXISTING_CLUSTER). Если базовый ближайший сосед выше порога не найден, создается новый UUID объекта (NEW_CUSTOMER_ENTITY).
Загрузка примеров записей о добавлении дополнительных пакетов
Чтобы создать incremental_daily_intake, вставьте и выполните следующий код DDL в редакторе SQL BigQuery Studio:
CREATE OR REPLACE TABLE `identity_resolution.incremental_daily_intake` AS
SELECT * FROM UNNEST([
  STRUCT(
    'rec-9999-new-1' AS rec_id, 'erin' AS given_name, 'donaldson' AS surname,
    'E650' AS given_name_soundex, 'D543' AS surname_soundex,
    '19810427' AS date_of_birth, '2955815' AS soc_sec_id,
    '13 hawkesbury crescent aralee lewiston 7018' AS formatted_address, '7018' AS postcode
  ),
  STRUCT(
    'rec-9999-new-2' AS rec_id, 'hollie' AS given_name, 'lillie-hinrichs' AS surname,
    'H400' AS given_name_soundex, 'L446' AS surname_soundex,
    '19251130' AS date_of_birth, '4920253' AS soc_sec_id,
    '27 hemmings crescent kilvinton village banyo 4030' AS formatted_address, '4030' AS postcode
  ),
  STRUCT(
    'rec-9999-new-3' AS rec_id, 'sarah' AS given_name, 'ryan' AS surname,
    'S600' AS given_name_soundex, 'R500' AS surname_soundex,
    '20010101' AS date_of_birth, '999999999' AS soc_sec_id,
    '500 market st melbourne vic 3000' AS formatted_address, '3000' AS postcode
  ),
  STRUCT(
    'rec-9999-new-4' AS rec_id, 'zzyzx' AS given_name, 'qx-vonderland' AS surname,
    'Z220' AS given_name_soundex, 'Q215' AS surname_soundex,
    '19991231' AS date_of_birth, '999887766' AS soc_sec_id,
    '9999 zulu orbit station moon-base alpha 9999' AS formatted_address, '9999' AS postcode
  )
]);
Выполнить запрос на сопоставление дельты
Чтобы выполнить дельта-сопоставление с базовым набором данных, запустите в редакторе SQL BigQuery следующий запрос:
CREATE OR REPLACE TABLE `identity_resolution.incremental_resolved_customers` AS
WITH historical_resolved_base AS (
  SELECT c.rec_id, c.given_name, c.surname, c.given_name_soundex, c.surname_soundex, c.date_of_birth, c.soc_sec_id, c.formatted_address, c.postcode, r.canonical_customer_id
  FROM `identity_resolution.customer_nodes_cleaned` c
  JOIN (
    SELECT canonical_customer_id, node_id
    FROM `identity_resolution.resolved_customers`, UNNEST(customer_records) AS node_id
  ) r ON c.rec_id = r.node_id
),
incremental_intake AS (
  SELECT
    rec_id AS new_rec_id, given_name, surname, given_name_soundex, surname_soundex, date_of_birth, soc_sec_id, formatted_address, postcode,
    CONCAT('Name: ', CONCAT(given_name, ' ', surname), '; Address: ', formatted_address, '; DOB: ', date_of_birth, '; SSN: ', soc_sec_id) AS profile_text
  FROM `identity_resolution.incremental_daily_intake`
),
rule_delta_matches AS (
  SELECT
    i.new_rec_id,
    h.canonical_customer_id AS matched_canonical_id,
    h.rec_id AS matched_baseline_rec_id,
    (
      0.30 * (CASE WHEN i.soc_sec_id = h.soc_sec_id AND i.soc_sec_id != '' THEN 1.0 ELSE 0.0 END) +
      0.20 * (1.0 - (EDIT_DISTANCE(i.surname, h.surname) / GREATEST(LENGTH(i.surname), LENGTH(h.surname), 1))) +
      0.20 * (1.0 - (EDIT_DISTANCE(i.given_name, h.given_name) / GREATEST(LENGTH(i.given_name), LENGTH(h.given_name), 1))) +
      0.15 * (CASE WHEN i.date_of_birth = h.date_of_birth THEN 1.0 ELSE 0.0 END) +
      0.15 * (1.0 - (EDIT_DISTANCE(i.formatted_address, h.formatted_address) / GREATEST(LENGTH(i.formatted_address), LENGTH(h.formatted_address), 1)))
    ) AS match_score
  FROM incremental_intake i
  JOIN historical_resolved_base h
    ON (i.soc_sec_id = h.soc_sec_id AND i.soc_sec_id != '')
    OR (i.date_of_birth = h.date_of_birth AND i.given_name_soundex = h.given_name_soundex)
),
vector_intake_embeddings AS (
  S>ELECT new_rec_id, AI.EMBED(profile>_text, connection_id = 'us.address_val_conn', endpoint = 'text-embedding-005').result AS text_embedding
  FROM incremental_intake
),
vector_delta_matches AS (
  SELECT
    v.query.new_rec_id,
    h.canonical_customer_id AS matched_canonical_id,
    h.rec_id AS matched_baseline_rec_id,
    ROUND(1.0 - v.distance, 4) AS match_score
  FROM VECTOR_SEARCH(
    TABLE `identity_resolution.customer_embeddings>`,
    'text_embedd>ing',
    TABLE vector_intake_embeddings,
    top_k = 3,
    distance_type = 'COSINE'<
  ) v
  JOIN historical_resolved_base h ON v.base.rec_id = h.rec_id
  WHERE v.distance = 0.20
),
combined_delta AS (
  SELECT
    new_rec_id, matched_canonical_id, matched_baseline_rec_id, matc>h_score,
    'RULE_BASED' AS match_strategy
  FROM rule_delta_matches WHERE match_score = 0.55

  UNION ALL

  SELECT
    new_rec_id, matched_canonical_id, matched_baseline_rec_id, match_score,
    'VECTOR_SEARCH' AS match_strategy
  FROM vector_delta_matches
),
aggregated_delta AS (
  SELECT
    new_rec_id,
    matched_canonical_id,
    ARRAY_AGG(matched_baseline_rec_id ORDER BY match_score DESC LIMIT 1)[OFFSET(0)] AS matched_ba>seline_rec_id,
    MAX(match_score) AS match_score,
    CASE
      WHEN COUNT(DISTINCT match_strategy)  1 THEN 'BOTH'
      ELSE MAX(match_strategy)
    END AS match_strategy
  FROM combined_delta
  GROUP BY new_rec_id, matched_canonical_id
),
best_matches AS (
  SELECT
    new_rec_id,
    matched_canonical_id,
    matched_baseline_rec_id,
    match_score,
    match_strategy,
    ROW_NUMBER() OVER(PARTITION BY new_rec_id ORDER BY match_score DESC) AS rank
  FROM aggregated_delta
)
SELECT
  i.new_rec_id AS record_id,
  i.given_name, i.surname,
  COALESCE(b.matched_canonical_id, GENERATE_UUID()) AS persistent_canonical_customer_id,
  h.canonical_household_id AS assigned_household_id,
  CASE WHEN b.matched_canonical_id IS NOT NULL THEN 'MATCHED_TO_EXISTING_CLUSTER' ELSE 'NEW_CUSTOMER_ENTITY' END AS assignment_type,
  b.matched_baseline_rec_id,
  b.match_score,
  COALESCE(b.match_strategy, 'NONE') AS match_strategy
FROM incremental_intake i
LEFT JOIN best_matches b ON i.new_rec_id = b.new_rec_id AND b.rank = 1
LEFT JOIN `identity_resolution.primary_household_edges` h ON b.matched_canonical_id = h.canonical_customer_id;
Запросите результаты дополнительного разрешения:
SELECT record_id, persistent_canonical_customer_id, assigned_household_id, assignment_type, match_score, match_strategy
FROM `identity_resolution.incremental_resolved_customers`;
Вы должны увидеть примерно следующее:
record_id | persistent_canonical_customer_id | assigned_household_id | assignment_type | match_score | match_strategy |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
10. Консолидация кластеров и стабильность кластеров (перекрытие 1-ε)
В производственных корпоративных системах команды обычно периодически (например, еженедельно или ежемесячно) перекластеризуют весь граф, чтобы включить новые ребра и источники данных. По мере формирования новых связей полная перекластеризация графа может привести к произвольному сдвигу или изменению идентификаторов кластеров при выполнении конвейера.
Чтобы поддерживать постоянные идентификаторы клиентов для последующих систем CRM, CDP и платежных систем, стабильность кластера оценивает перекрытие узлов между текущими кластерами Run (t) и предыдущими кластерами Run (t-1) с использованием порога перекрытия (1 - ε) (где ε = 0,30, что требует минимального перекрытия узлов 70 %).
Если у нового кластера, вычисленного в ходе выполнения (t), не менее 70 % записей совпадает с записями кластера, вычисленного в ходе выполнения (t-1), то он наследует постоянный идентификатор клиента (STABLE_EVOLUTION). Новые кластеры получают новые UUID (NEW_CLUSTER_CREATED).
Выполнить запрос на пересечение и стабильность кластеров
Чтобы заполнить таблицу stable_resolved_customers, выполните в редакторе SQL BigQuery Studio следующий запрос:
CREATE OR REPLACE TABLE `identity_resolution.stable_resolved_customers` AS
WITH previous_run_clusters AS (
  SELECT
    canonical_customer_id AS previous_persistent_id,
    node_id,
    COUNT(*) OVER (PARTITION BY canonical_customer_id) AS previous_cluster_size
  FROM `identity_resolution.resolved_customers`, UNNEST(customer_records) AS node_id
),
current_run_clusters AS (
  SELECT
    new_cluster_id,
    node_id,
    COUNT(*) OVER (PARTITION BY new_cluster_id) AS current_cluster_size
  FROM (
    SELECT
      canonical_customer_id AS new_cluster_id,
      node_id
    FROM `identity_resolution.resolved_customers`, UNNEST(customer_records) AS node_id
    UNION ALL
    SELECT
      persistent_canonical_customer_id AS new_cluster_id,
      record_id AS node_id
    FROM `identity_resolution.incremental_resolved_customers`
  )
),
cluster_intersections AS (
  SELECT
    c.new_cluster_id,
    p.previous_persistent_id,
    c.current_cluster_size,
    p.previous_cluster_size,
    COUNT(c.node_id) AS shared_node_count,
    COUNT(c.node_id) / GREATEST(p.previous_cluster_size, 1) AS overlap_fraction
  FROM current_run_clusters c
  JOIN previous_run_clusters p ON c.node_id = p.node_id
  GROUP BY c.new_cluster_id, p.previous_persistent_id, c.current_cluster_size, p.previous_cluster_size
),
best_matching_previous_cluster AS (
  SELECT
    new_cluster_id,
    previous_persistent_id,
    shared_node_count,
    overlap_fraction,
    ROW_NUMBER() OVER (PARTITION BY new_cluster_id ORDER BY overlap_fraction DESC) AS rank
  FROM cluster_intersections
  WHERE overlap_fraction >= 0.70
)
SELECT
  c.new_cluster_id AS raw_cluster_id,
  COALESCE(b.previous_persistent_id, GENERATE_UUID()) AS persistent_canonical_customer_id,
  ARRAY_AGG(c.node_id) AS customer_records,
  COUNT(c.node_id) AS record_count,
  COALESCE(MAX(b.shared_node_count), 0) AS shared_node_count,
  COALESCE(MAX(b.overlap_fraction), 0.0) AS overlap_fraction,
  CASE
    WHEN b.previous_persistent_id IS NOT NULL THEN 'STABLE_EVOLUTION'
    ELSE 'NEW_CLUSTER_CREATED'
  END AS cluster_status
FROM current_run_clusters c
LEFT JOIN best_matching_previous_cluster b
  ON c.new_cluster_id = b.new_cluster_id AND b.rank = 1
GROUP BY c.new_cluster_id, b.previous_persistent_id;
Как посмотреть отфильтрованные записи для добавочного импорта
Выполните этот запрос, чтобы проверить статус стабильности кластера для ежедневных записей о потреблении:
SELECT
  s.persistent_canonical_customer_id,
  node_id AS record_id,
  h.canonical_household_id AS assigned_household_id,
  s.cluster_status
FROM `identity_resolution.stable_resolved_customers` s, UNNEST(s.customer_records) AS node_id
LEFT JOIN `identity_resolution.primary_household_edges` h
  ON s.persistent_canonical_customer_id = h.canonical_customer_id
WHERE node_id IN ('rec-9999-new-1', 'rec-9999-new-2', 'rec-9999-new-3', 'rec-9999-new-4')
ORDER BY record_id;
Вы должны увидеть примерно следующее:
persistent_canonical_customer_id | record_id | assigned_household_id | cluster_status |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
11. Организовать
Чтобы избежать дальнейших расходов в аккаунте Google Cloud, удалите развернутые ресурсы и набор данных BigQuery.
В Cloud Shell выполните следующую команду:
# 1. Delete BigQuery Dataset
bq rm -r -f -d ${GCP_PROJECT}:${DATASET_ID}

# 2. Delete Cloud Function (2nd-Gen)
gcloud functions delete validate_address_udf --region=${REGION} --gen2 --quiet

# 3. Delete BigQuery Cloud Connection
bq rm -f --connection US.address_val_conn
Если вы создали для этой лабораторной работы отдельный проект Google Cloud, вы можете удалить его:
gcloud projects delete ${GCP_PROJECT}
12. Поздравляю!
Поздравляем! Вы успешно создали комплексный механизм идентификации клиентов в Google Cloud BigQuery, используя граф свойств BigQuery, запросы ISO GQL, гибридное сопоставление по сходству, инкрементное дельта-сопоставление и гарантии стабильности постоянного кластера.
Что вы узнали
- Как развернуть функцию Cloud Functions второго поколения и сделать ее доступной в качестве удаленной функции BigQuery.
- Как предварительно обработать демографические данные клиентов с помощью фонетического кодирования
SOUNDEXи проверки адресов. - Как заблокировать кандидатов и рассчитать гибридные оценки сходства, используя расстояние Левенштейна (
EDIT_DISTANCE) и коэффициент Жаккара. - Как создать граф свойств BigQuery (
CREATE PROPERTY GRAPH) на основе таблиц узлов и ребер. - Как запрашивать пути графа с помощью ISO GQL (
GRAPH_TABLE) с квантификаторами k-hop{1, 2}. - Как разрешать канонические кластеры клиентов и оценивать эффективность модели по фундаментальным истинным показателям.
- Как выполнять добавочное сопоставление дельты для ежедневных пакетных загрузок без полной повторной обработки набора данных.
- Как применить пороговое значение перекрытия (1 - ε), чтобы обеспечить стабильность кластеров при разных запусках конвейера.
Дальнейшие действия
- Ознакомьтесь с документацией по графам свойств BigQuery.
- Попробуйте использовать BigQuery Vector Search и текстовые эмбеддинги Vertex AI для семантического подбора кандидатов.
- Подробнее об удаленных функциях BigQuery для масштабируемых интеграций внешних API…