
1. Przegląd
Cloud Dataproc to zarządzana usługa Spark i Hadoop, która umożliwia korzystanie z narzędzi do danych open source do przetwarzania wsadowego, wykonywania zapytań, strumieniowania i uczenia maszynowego. Automatyzacja Cloud Dataproc pomaga szybko tworzyć klastry, łatwo nimi zarządzać i oszczędzać pieniądze, wyłączając je, gdy nie są potrzebne. Dzięki mniejszej ilości czasu i pieniędzy poświęcanych na administrację możesz skupić się na zadaniach i danych.
Ten samouczek został opracowany na podstawie informacji ze strony https://cloud.google.com/dataproc/overview
Czego się nauczysz
- Jak utworzyć zarządzany klaster Cloud Dataproc (z wstępnie zainstalowanym Apache Spark).
- Przesyłanie zadania Spark
- Zmiana rozmiaru klastra
- Jak połączyć się z węzłem głównym klastra Dataproc za pomocą protokołu SSH
- Jak używać gcloud do sprawdzania klastrów, zadań i reguł zapory sieciowej
- Jak wyłączyć klaster
Czego potrzebujesz
Jak zamierzasz korzystać z tego samouczka?
Jak oceniasz korzystanie z usług Google Cloud Platform?
2. Konfiguracja i wymagania
Samodzielne konfigurowanie środowiska
- Zaloguj się w konsoli Google Cloud i utwórz nowy projekt lub użyj istniejącego. (Jeśli nie masz jeszcze konta Gmail lub G Suite, musisz je utworzyć).
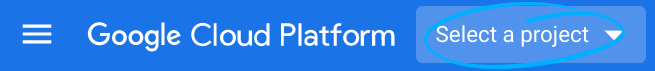
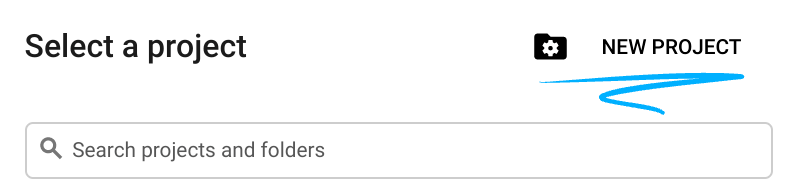
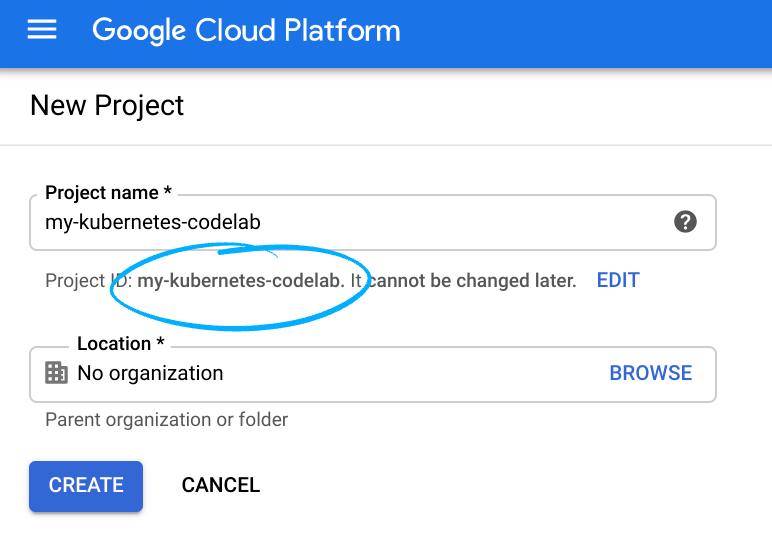
Zapamiętaj identyfikator projektu, czyli unikalną nazwę we wszystkich projektach Google Cloud (podana powyżej nazwa jest już zajęta i nie będzie działać w Twoim przypadku). W dalszej części tego laboratorium będzie on nazywany PROJECT_ID.
- Następnie musisz włączyć rozliczenia w Cloud Console, aby korzystać z zasobów Google Cloud.
Ukończenie tego laboratorium nie powinno wiązać się z dużymi kosztami, a nawet z żadnymi. Wykonaj instrukcje z sekcji „Czyszczenie”, w której znajdziesz informacje o tym, jak wyłączyć zasoby, aby uniknąć naliczenia opłat po zakończeniu tego samouczka. Nowi użytkownicy Google Cloud mogą skorzystać z programu bezpłatnego okresu próbnego o wartości 300 USD.
3. Włączanie interfejsów Cloud Dataproc i Google Compute Engine API
Kliknij ikonę menu w lewym górnym rogu ekranu.

Z menu wybierz Menedżer interfejsów API.

Kliknij Włącz interfejsy API i usługi.

W polu wyszukiwania wyszukaj „Compute Engine”. Na liście wyników, która się pojawi, kliknij „Google Compute Engine API”.

Na stronie Google Compute Engine kliknij Włącz.

Po włączeniu kliknij strzałkę w lewo, aby wrócić.
Teraz wyszukaj „Google Cloud Dataproc API” i też go włącz.

4. Uruchamianie Cloud Shell
Ta maszyna wirtualna oparta na Debianie zawiera wszystkie potrzebne narzędzia dla programistów. Zawiera również stały katalog domowy o pojemności 5 GB i działa w Google Cloud, co znacznie zwiększa wydajność sieci i usprawnia proces uwierzytelniania. Oznacza to, że do ukończenia tego ćwiczenia potrzebujesz tylko przeglądarki (działa ona na Chromebooku).
- Aby aktywować Cloud Shell w konsoli Cloud, kliknij Aktywuj Cloud Shell
(udostępnienie środowiska i połączenie się z nim powinno zająć tylko kilka chwil).
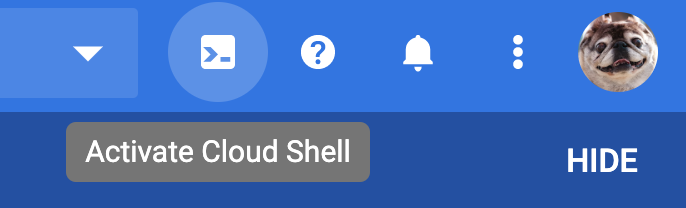
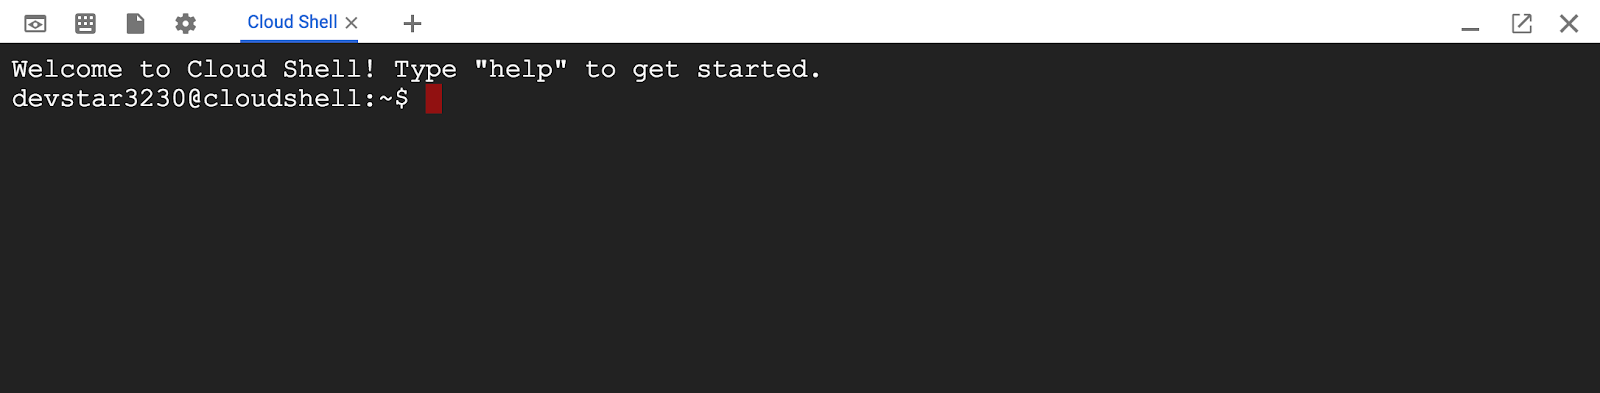
Po połączeniu z Cloud Shell zobaczysz, że uwierzytelnianie zostało już przeprowadzone, a projekt jest już ustawiony na Twój identyfikator projektu PROJECT_ID.
gcloud auth list
Wynik polecenia
Credentialed accounts:
 - <myaccount>@<mydomain>.com (active)
gcloud config list project
Wynik polecenia
[core]
project = <PROJECT_ID>
Jeśli z jakiegoś powodu projekt nie jest ustawiony, po prostu wydaj to polecenie:
gcloud config set project <PROJECT_ID>
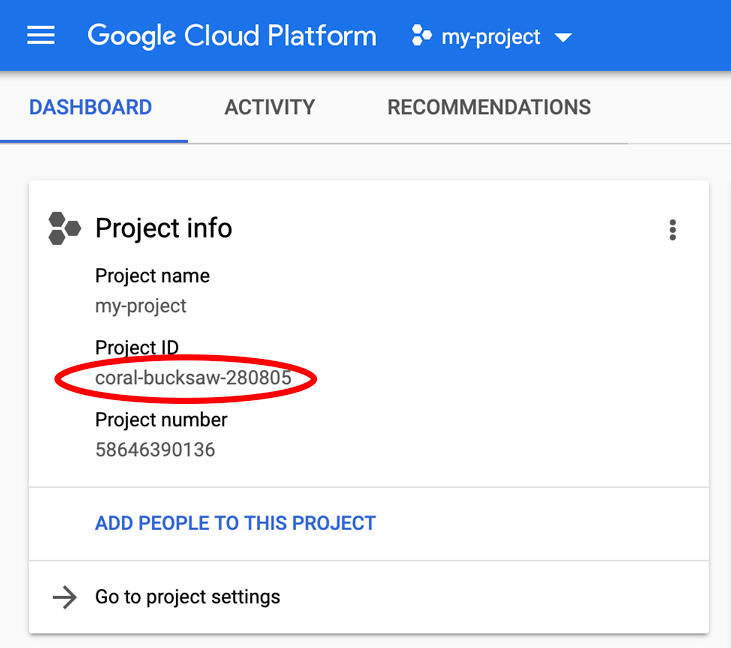
Szukasz urządzenia PROJECT_ID? Sprawdź, jakiego identyfikatora użyto w krokach konfiguracji, lub wyszukaj go w panelu konsoli Cloud:
Cloud Shell domyślnie ustawia też niektóre zmienne środowiskowe, które mogą być przydatne podczas wykonywania kolejnych poleceń.
echo $GOOGLE_CLOUD_PROJECT
Wynik polecenia
<PROJECT_ID>
- Na koniec ustaw domyślną strefę i konfigurację projektu.
gcloud config set compute/zone us-central1-f
Możesz wybrać różne strefy. Więcej informacji znajdziesz w artykule Regiony i strefy.
5. Utwórz klaster Cloud Dataproc
Po uruchomieniu Cloud Shell możesz użyć wiersza poleceń, aby wywołać polecenie gcloud z pakietu SDK Cloud lub inne narzędzia dostępne w instancji maszyny wirtualnej.
Wybierz nazwę klastra, której chcesz użyć w tym module:
$ CLUSTERNAME=${USER}-dplab
Zacznijmy od utworzenia nowego klastra:
$ gcloud dataproc clusters create ${CLUSTERNAME} \
  --region=us-central1 \
  --scopes=cloud-platform \
  --tags codelab \
  --zone=us-central1-c
Domyślne ustawienia klastra, które obejmują 2 węzły robocze, powinny wystarczyć na potrzeby tego samouczka. Powyższe polecenie zawiera opcję --zone, która umożliwia określenie strefy geograficznej, w której zostanie utworzony klaster, oraz 2 opcje zaawansowane: --scopes i --tags. Ich działanie wyjaśniamy poniżej, gdy używasz funkcji, które one włączają. Informacje o używaniu flag wiersza poleceń do dostosowywania ustawień klastra znajdziesz w dokumentacji polecenia gcloud dataproc clusters create pakietu Cloud SDK.
6. Przesyłanie zadania Spark do klastra
Zadanie możesz przesłać za pomocą żądania Cloud Dataproc API jobs.submit, narzędzia wiersza poleceń gcloud lub konsoli Google Cloud Platform. Możesz też połączyć się z instancją maszyny w klastrze za pomocą SSH, a następnie uruchomić zadanie z tej instancji.
Prześlijmy zadanie za pomocą narzędzia gcloud z wiersza poleceń Cloud Shell:
$ gcloud dataproc jobs submit spark --cluster ${CLUSTERNAME} \
  --class org.apache.spark.examples.SparkPi \
  --jars file:///usr/lib/spark/examples/jars/spark-examples.jar -- 1000
W trakcie wykonywania zadania w oknie Cloud Shell będą wyświetlane wyniki.
Przerwij dane wyjściowe, wpisując Control-C. Spowoduje to zatrzymanie polecenia gcloud, ale zadanie będzie nadal uruchomione w klastrze Dataproc.
7. Wyświetlanie listy zadań i ponowne łączenie
Drukowanie listy zadań:
$ gcloud dataproc jobs list --cluster ${CLUSTERNAME}
Najnowsze przesłane zadanie znajduje się u góry listy. Skopiuj identyfikator zadania i wklej go w miejsce „jobId” w poniższym poleceniu. Polecenie ponownie połączy się z określonym zadaniem i wyświetli jego dane wyjściowe:
$ gcloud dataproc jobs wait jobId
Po zakończeniu zadania dane wyjściowe będą zawierać przybliżoną wartość liczby Pi.

8. Zmiana rozmiaru klastra
Aby przyspieszyć wykonywanie większych obliczeń, możesz dodać do klastra więcej węzłów. Dataproc umożliwia dodawanie i usuwanie węzłów z klastra w dowolnym momencie.
Sprawdź konfigurację klastra:
$ gcloud dataproc clusters describe ${CLUSTERNAME}
Zwiększ rozmiar klastra, dodając węzły z możliwością wywłaszczania:
$ gcloud dataproc clusters update ${CLUSTERNAME} --num-secondary-workers=2
Ponownie sprawdź klaster:
$ gcloud dataproc clusters describe ${CLUSTERNAME}
Zwróć uwagę, że oprócz workerConfig z oryginalnego opisu klastra jest teraz też secondaryWorkerConfig, który zawiera 2 instanceNames dla pracowników z możliwością przerwania. Dataproc pokazuje stan klastra jako gotowy, gdy nowe węzły są uruchamiane.
Ponieważ zaczęliśmy od 2 węzłów, a teraz mamy 4, zadania Spark powinny działać około 2 razy szybciej.
9. Nawiązywanie połączenia SSH z klastrem
Połącz się przez SSH z węzłem głównym, którego nazwa instancji jest zawsze nazwą klastra z dopiskiem -m:
$ gcloud compute ssh ${CLUSTERNAME}-m --zone=us-central1-c
Gdy po raz pierwszy uruchomisz polecenie ssh w Cloud Shell, wygeneruje ono klucze ssh dla Twojego konta. Możesz wybrać hasło wielowyrazowe lub użyć pustego hasła wielowyrazowego i zmienić je później za pomocą ssh-keygen.
Sprawdź nazwę hosta na instancji:
$ hostname
Ponieważ podczas tworzenia klastra podano --scopes=cloud-platform, w klastrze można uruchamiać polecenia gcloud. Wyświetl listę klastrów w projekcie:
$ gcloud dataproc clusters list
Po zakończeniu wyloguj się z połączenia SSH:
$ logout
10. Sprawdzanie tagów
Podczas tworzenia klastra pojawiła się opcja --tags dodania tagu do każdego węzła w klastrze. Tagi służą do dołączania reguł zapory sieciowej do poszczególnych węzłów. W tym module nie utworzyliśmy żadnych pasujących reguł zapory sieciowej, ale nadal możesz sprawdzić tagi węzła i reguły zapory sieciowej w sieci.
Wydrukuj opis węzła głównego:
$ gcloud compute instances describe ${CLUSTERNAME}-m --zone us-central1-c
Pod koniec danych wyjściowych poszukaj znaku tags: i sprawdź, czy zawiera on znak codelab.
Wydrukuj reguły zapory sieciowej:
$ gcloud compute firewall-rules list
Zwróć uwagę na kolumny SRC_TAGS i TARGET_TAGS. Dołączając tag do reguły zapory sieciowej, możesz określić, że ma ona być używana we wszystkich węzłach, które mają ten tag.
11. Wyłączanie klastra
Klaster możesz wyłączyć za pomocą żądania interfejsu Cloud Dataproc API clusters.delete, z wiersza poleceń za pomocą pliku wykonywalnego gcloud dataproc clusters delete lub w konsoli Google Cloud Platform.
Wyłączmy klaster za pomocą wiersza poleceń Cloud Shell:
$ gcloud dataproc clusters delete ${CLUSTERNAME} --region us-central1
12. Gratulacje!
Wiesz już, jak utworzyć klaster Dataproc, przesłać zadanie Spark, zmienić rozmiar klastra, zalogować się w węźle głównym za pomocą SSH, sprawdzić klastry, zadania i reguły zapory sieciowej za pomocą gcloud oraz wyłączyć klaster za pomocą gcloud.
Więcej informacji
- Dokumentacja Dataproc: https://cloud.google.com/dataproc/overview
- Wprowadzenie do Dataproc przy użyciu konsoli
Licencja
Ten utwór jest dostępny na licencji Creative Commons Attribution 3.0 Generic oraz Apache 2.0.