
1. はじめに
BigQuery Graph、BigQuery Conversational Analytics、BigQuery Agent アナリティクス SDK は現在、Google Cloud でプレビュー版として提供されています。BigQuery Agent Analytics プラグインが一般提供(GA)になりました。この Codelab の例では、合成データを使用します。
自律型 AI エージェントが運用上の責任(融資申請の評価、マーケティング予算の管理、アクセス リクエストの承認など)を担うにつれて、組織は意思決定を監査し、説明できるようになる必要があります。エージェントの意思決定の正確なコンテキスト、検討された代替案、最終的な根拠を再構築することは、コンプライアンス、リスク管理、運用の信頼性にとって不可欠です。
この Codelab では、BigQuery Agent Analytics SDK を使用して、外部のグラフ データベースや ETL パイプラインを使用せずに、未加工のエージェント イベントログを エージェント コンテキスト グラフ(BigQuery Graph のエージェントの意思決定のクエリ可能なグラフ)に変換します。
主な用語
- エージェントの意思決定トレース - エージェント自身の実行から取得された意思決定レベルの証拠。エージェントが検討したオプション、アクセスしたデータ、コミットした結果。
- エージェント コンテキスト グラフ - これらのトレースが具体化される BigQuery Graph の型付きのクエリ可能なグラフ。これは、業界のコンテキスト グラフの概念(エージェントが生成と消費の両方を行う、永続的な時間リンクの決定コンテキスト レイヤ)のエージェント スコープのインスタンスです。「Agent」修飾子は、エンタープライズ全体のコンテキスト レイヤではなく、独自のエージェントの実行にスコープを設定します。
この Codelab では、bqaa context-graph が agent_events からエージェントの決定トレースを抽出し、GQL でクエリできるエージェント コンテキスト グラフに具体化します。これは、コンテキスト グラフが決定トレースから構築される業界パターンに沿ったものです。

作成するアプリの概要
- 一般的なエージェントの意思決定フロー(リクエストの受信、エージェントによるオプションの検討、結果のコミット)をモデル化したエージェント コンテキスト グラフ(BigQuery Graph を使用)。
- 合成イベント コーパスを含む
agent_eventsテーブル。 - これらのイベントからグラフを塗りつぶす
bqaa context-graph実行。 - 単一の決定をエンドツーエンドでトレースする監査スタイルの GQL クエリ。
学習内容
- BigQuery Agent Analytics プラグインが
agent_eventsに書き込む方法。 - コンテキスト グラフが、テーブル DDL と
CREATE PROPERTY GRAPHスキーマという 2 つの宣言型アーティファクトだけで定義される仕組み。 - BigQuery Graph に対して
bqaa context-graphを実行する方法。 - GQL を使用してグラフをクエリする方法。
- エンタープライズ デプロイ用に SDK がサポートする本番環境グレードの機能。
必要なもの
- 課金を有効にした Google Cloud プロジェクト
- そのプロジェクトのオーナーまたは編集者のロール。BigQuery データセットを作成し、IAM を付与します。
gcloudCLI がインストールされて認証されているか、Cloud Shell にアクセスできること。- Python 3.10 以降。
- BigQuery SQL の知識。GQL の知識は必要ありません。
この Codelab は、BigQuery Graph を初めて使用する方を含め、あらゆるレベルのデベロッパーを対象としています。
この Codelab で作成するリソースの費用はごくわずかです。最終ステップですべてを削除するため、アイドル状態のデータセットに対して課金されることはありません。
推定所要時間: この Codelab の所要時間はおよそ 35 分です。
2. 始める前に
プロジェクトとリージョンを選択する
Cloud Shell またはローカル ターミナルを開きます。
export PROJECT_ID="your-project-id"
export REGION="us-central1"
export DATASET="agent_analytics_demo"
gcloud config set project "$PROJECT_ID"
単一の DATASET 変数には、未加工の agent_events テーブルとマテリアライズド グラフテーブルの両方が保持されます。1 つのデータセットを使用することで、この Codelab をシンプルに保ちます。本番環境のデプロイでは、イベントとグラフを別々のデータセットに分割して、IAM をデータセットごとに狭く付与することがよくあります。
必要な API を有効にする
次のコマンドを実行して、この Codelab で使用する API を有効にします。
gcloud services enable \
    bigquery.googleapis.com \
    aiplatform.googleapis.com \
    --project="$PROJECT_ID"
SDK のデフォルトの抽出パスは BigQuery の AI.GENERATE 関数を呼び出すため、aiplatform.googleapis.com API が必要です。後で --extraction-mode=compiled-only を使用して決定論的抽出に切り替える場合、この API は不要になります。
BigQuery データセットを作成する
未加工の agent_events テーブルとマテリアライズド グラフテーブルの両方を保持するデータセットを作成します。
bq --location=US mk --dataset "$PROJECT_ID:$DATASET"
成功メッセージが表示されます。
Dataset 'your-project-id:agent_analytics_demo' successfully created.
データセットがすでに存在する場合、コマンドはエラーを返しますが、問題はありません。そのままにしておきます。
3. SDK をインストールする
Python 仮想環境を設定し、PyPI から SDK をインストールします。
python3 -m venv .venv
source .venv/bin/activate
pip install --upgrade pip
pip install bigquery-agent-analytics
bigquery-agent-analytics パッケージは BigQuery クライアント ライブラリをプルするため、このインストールはコードラボ全体で必要な唯一のインストールです。
インストールを確認します。
bqaa context-graph --help | head -8
CLI バナーが表示されます。
認証
ワークステーションをお使いの場合:
gcloud auth login
gcloud auth application-default login
Cloud Shell ユーザーはこの手順をスキップできます。認証情報はすでに構成されています。
4. Codelab のアーティファクトを取得する
この Codelab で必要なのは、すぐに使用できる 2 つのアーティファクト(テーブル DDL(物理グラフ テーブル)とプロパティ グラフ スキーマ(CREATE PROPERTY GRAPH))のみです。どちらも自分で作成する必要はありません。この Codelab ではこれらをそのまま使用します。アーティファクト フォルダの README に、これらを独自の意思決定ドメインに合わせて調整する方法が記載されています。
プロパティ グラフ スキーマは、グラフに含まれる内容に関する唯一の情報源です。BigQuery に 1 回適用すると、それ以降はデプロイされたグラフ自体がコントラクトになります。マテリアライズすると、bqaa context-graph はグラフの定義を BigQuery の INFORMATION_SCHEMA.PROPERTY_GRAPHS から(参照するテーブルのスキーマとともに)読み取り、抽出するエンティティとリレーションシップ、およびそれらの書き込み先を特定します。そのため、SQL ファイルがマテリアライザーに渡されることはありません。
この Codelab は自己完結型であるため、ダウンロードするものはありません。次のコマンドは、コンテキスト グラフ DDL を作業ディレクトリに書き込みます。その内容は、examples/context_graph/codelab/ で出荷されたアーティファクトと同一です。
作業ディレクトリを作成します。
mkdir -p ~/context-graph-codelab
cd ~/context-graph-codelab
コンテキスト グラフ DDL を記述します(context_graph_ddl.sql)。${PROJECT_ID} / ${DATASET} マーカーは、次のステップでファイルを適用するときに挿入されます。
cat > context_graph_ddl.sql <<'SQL'

-- Node and edge table DDL for the context-graph codelab.
--
-- `bqaa context-graph` writes into these tables on every run.
-- `session_id` and `extracted_at` are SDK metadata columns that
-- `bqaa context-graph` fills automatically; they are required on
-- every table behind the graph.
CREATE TABLE IF NOT EXISTS `${PROJECT_ID}.${DATASET}.decision_request` (
  request_id STRING, request_text STRING, requested_at TIMESTAMP,
  session_id STRING, extracted_at TIMESTAMP
);
CREATE TABLE IF NOT EXISTS `${PROJECT_ID}.${DATASET}.decision_option` (
  option_id STRING, option_label STRING, confidence FLOAT64,
  session_id STRING, extracted_at TIMESTAMP
);
CREATE TABLE IF NOT EXISTS `${PROJECT_ID}.${DATASET}.decision_outcome` (
  outcome_id STRING, status STRING, rationale STRING, decided_at TIMESTAMP,
  session_id STRING, extracted_at TIMESTAMP
);
CREATE TABLE IF NOT EXISTS `${PROJECT_ID}.${DATASET}.evaluates_option` (
  request_id STRING, option_id STRING,
  session_id STRING, extracted_at TIMESTAMP
);
CREATE TABLE IF NOT EXISTS `${PROJECT_ID}.${DATASET}.resulted_in` (
  request_id STRING, outcome_id STRING,
  session_id STRING, extracted_at TIMESTAMP
);

-- Graph DDL for the context-graph codelab.
--
-- Models a generic agent decision flow:
--   DecisionRequest -> evaluatesOption -> DecisionOption
--   DecisionRequest -> resultedIn       -> DecisionOutcome
CREATE OR REPLACE PROPERTY GRAPH `${PROJECT_ID}.${DATASET}.agent_decisions_graph`
  NODE TABLES (
    `${PROJECT_ID}.${DATASET}.decision_request` AS decision_request
      KEY (request_id)
      LABEL DecisionRequest PROPERTIES (request_id, request_text, requested_at),
    `${PROJECT_ID}.${DATASET}.decision_option` AS decision_option
      KEY (option_id)
      LABEL DecisionOption PROPERTIES (option_id, option_label, confidence),
    `${PROJECT_ID}.${DATASET}.decision_outcome` AS decision_outcome
      KEY (outcome_id)
      LABEL DecisionOutcome PROPERTIES (outcome_id, status, rationale, decided_at)
  )
  EDGE TABLES (
    `${PROJECT_ID}.${DATASET}.evaluates_option` AS evaluates_option
      KEY (request_id, option_id)
      SOURCE KEY (request_id) REFERENCES decision_request (request_id)
      DESTINATION KEY (option_id) REFERENCES decision_option (option_id)
      LABEL evaluatesOption,
    `${PROJECT_ID}.${DATASET}.resulted_in` AS resulted_in
      KEY (request_id, outcome_id)
      SOURCE KEY (request_id) REFERENCES decision_request (request_id)
      DESTINATION KEY (outcome_id) REFERENCES decision_outcome (outcome_id)
      LABEL resultedIn
  );
SQL
ファイルが配置されていることを確認します。
ls
1 つのファイルが表示されます。
context_graph_ddl.sql
この決定フローには、3 つのノードタイプと 2 つの異種エッジがあります。
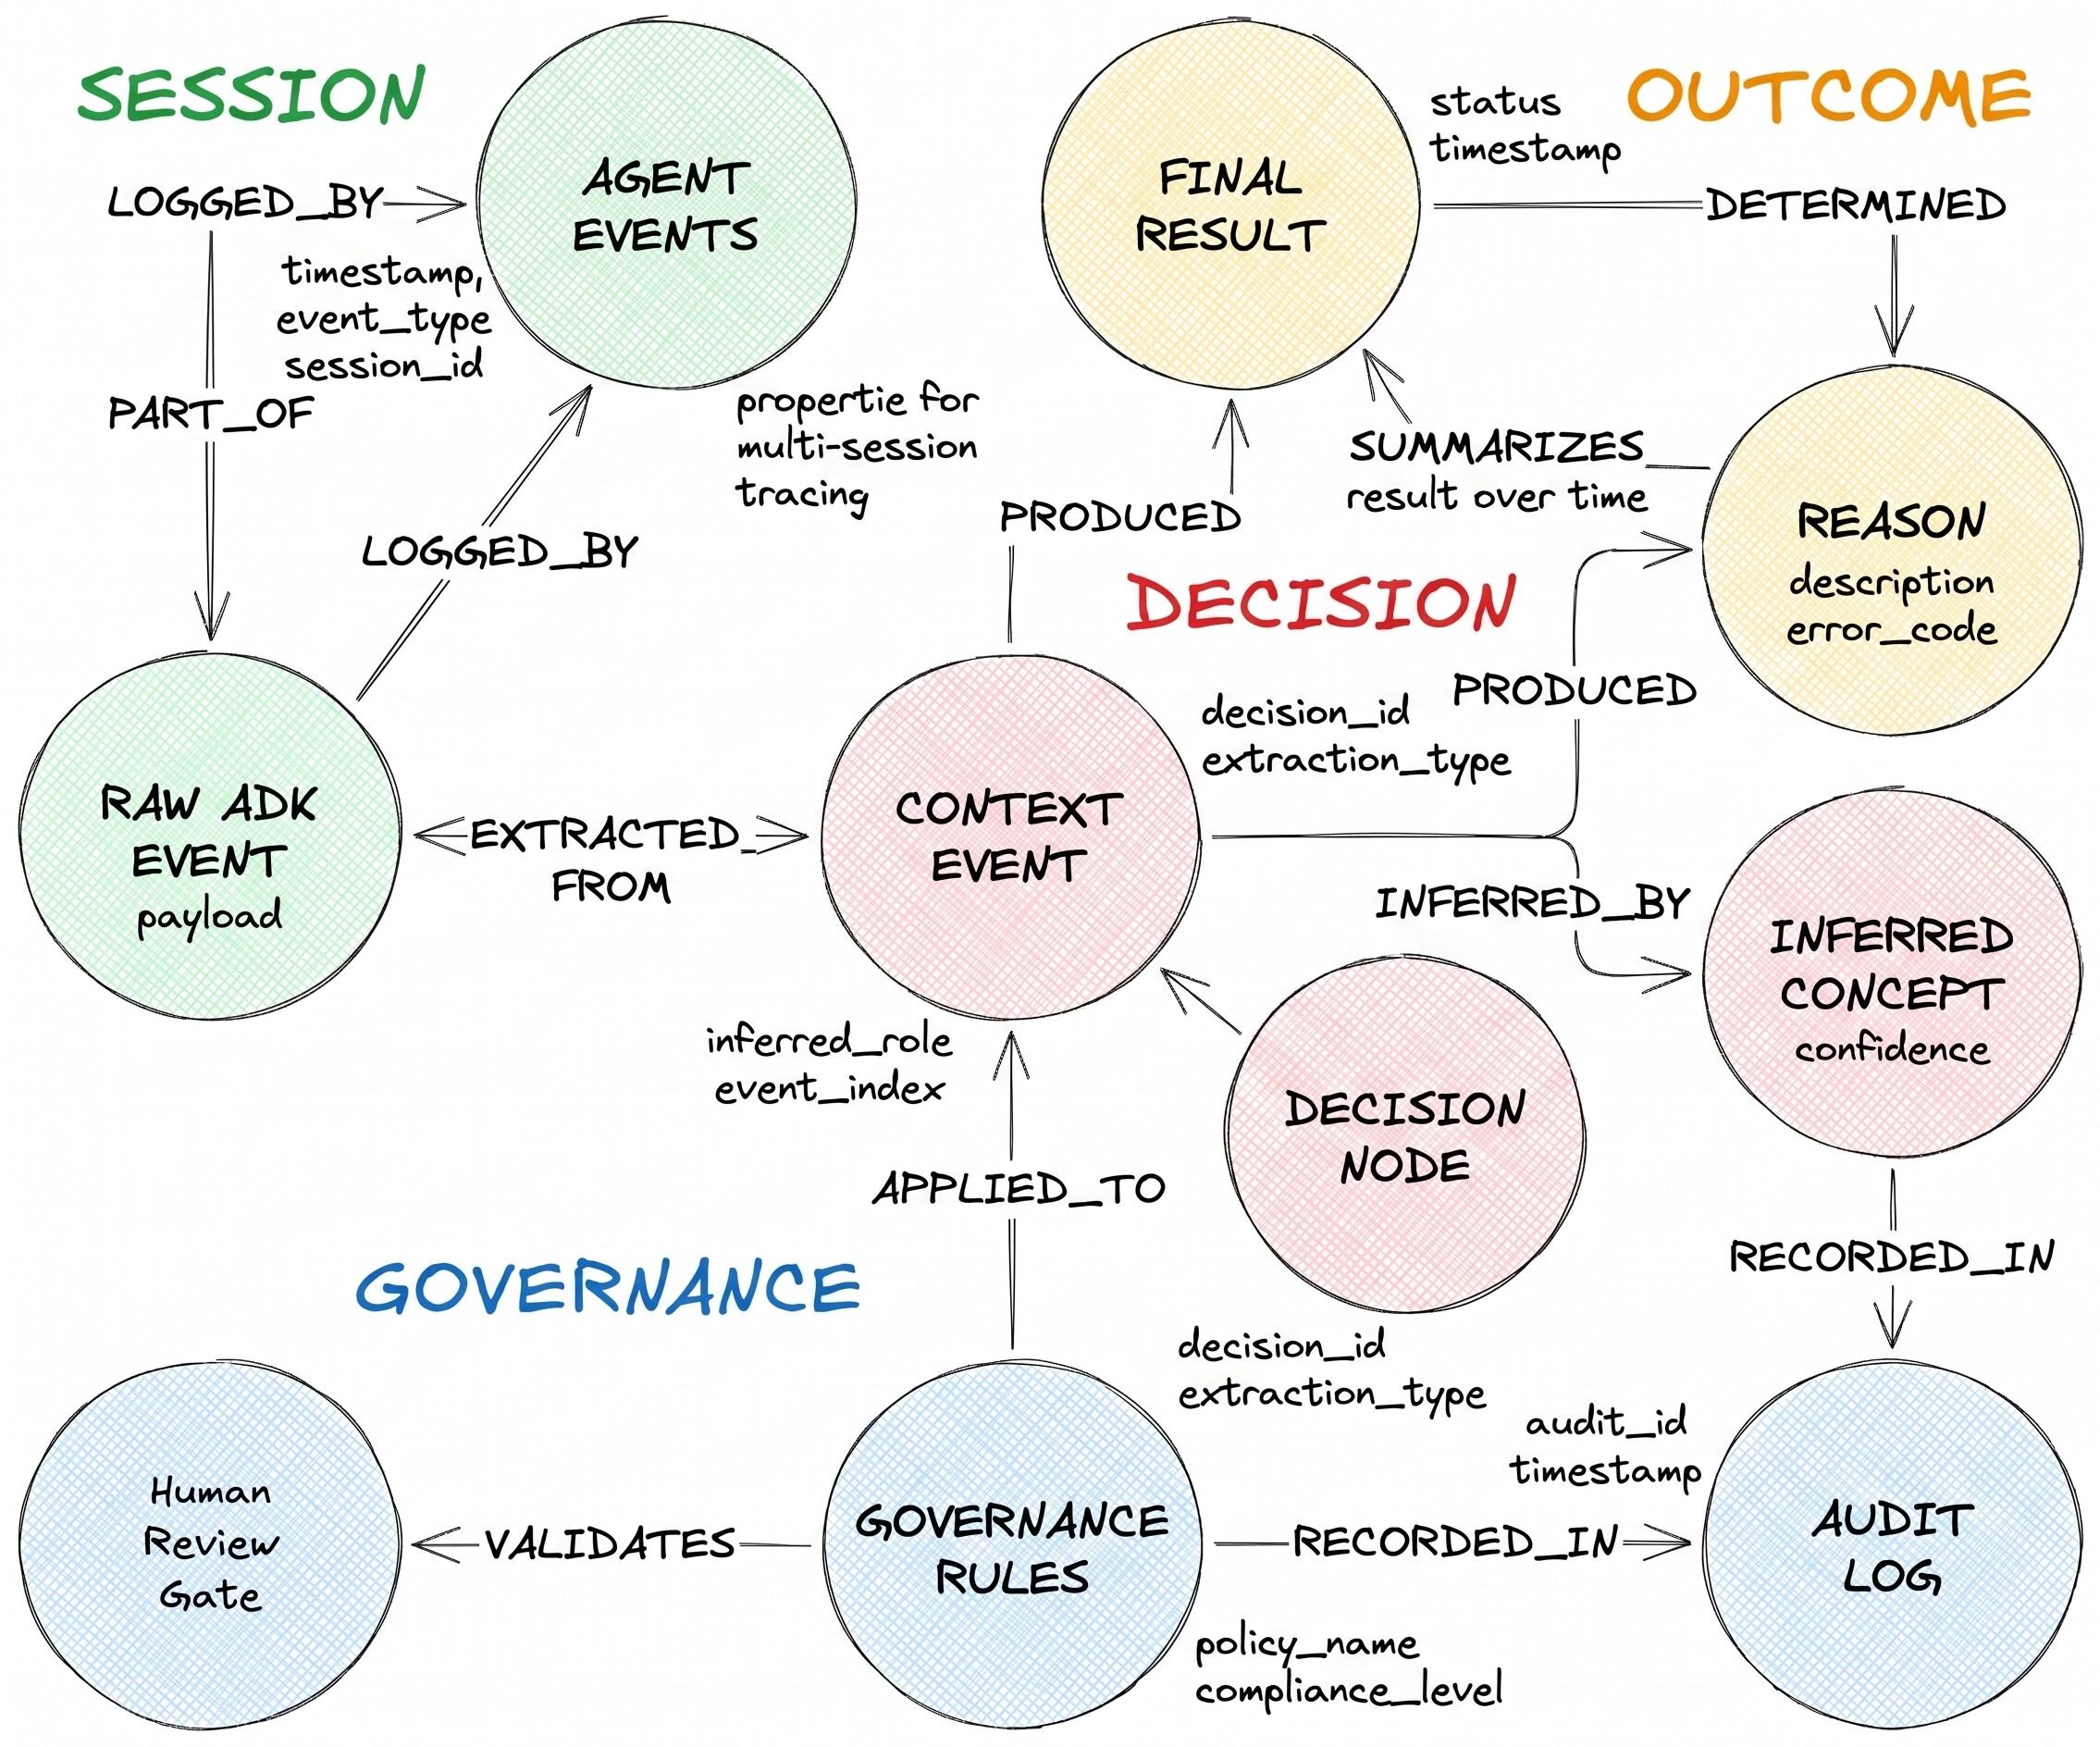
DecisionRequest はエージェントが受け取った質問です。DecisionOption は、エージェントが検討した代替案の 1 つです。DecisionOutcome は、確定した選択と理由を記録します。
5. プロパティ グラフのスキーマを適用する
bqaa context-graph は BigQuery テーブルに書き込むため、最初の実行前に存在している必要があります。context_graph_ddl.sql は、まず 5 つのテーブルを作成し、それらを参照するプロパティ グラフを作成します(まだ存在しないテーブルを指す CREATE PROPERTY GRAPH は BigQuery で拒否されます)。したがって、1 回の適用ですべてが設定されます。
envsubst < context_graph_ddl.sql | bq query --use_legacy_sql=false
5 つの CREATE TABLE の結果と 1 つの CREATE PROPERTY GRAPH の結果が表示されます。DDL はべき等であるため、安全に再実行できます。
これがスキーマの唯一の作業であり、これらの SQL ファイルが使用される唯一のタイミングです。BigQuery はグラフの定義を記録し、bqaa context-graph は名前で INFORMATION_SCHEMA.PROPERTY_GRAPHS から読み取ります。マテリアライザーに渡す個別のファイルはなく、GQL でクエリする内容とマテリアライズされる内容は常に同じです。これらは同じデプロイされたグラフです。
6. サンプル エージェント イベントを生成する
本番環境では、ADK エージェントの実行時に BigQuery Agent Analytics プラグインがイベントを自動的にキャプチャします。このスニペットは参考用です。この Codelab では実行しません。
from google.adk.plugins import BigQueryAgentAnalyticsPlugin

plugin = BigQueryAgentAnalyticsPlugin(
    project_id="your-project-id",
    dataset_id="agent_analytics_demo",
)
runner = Runner(agent=root_agent, plugins=[plugin])
この Codelab では、同じ形状の行を agent_events に直接書き込む小さな合成イベント ジェネレータを使用します。実行する:
bqaa seed-events \
    --project-id "$PROJECT_ID" \
    --dataset-id "$DATASET" \
    --sessions 5
このコマンドは JSON レポートを出力します。5 つのセッションの場合、"events_generated": 30、"events_inserted": 30、"ok": true が表示されます。
コーパスの概要(セッション数、イベント数、期間など)を 1 行で確認できます。
bq query --use_legacy_sql=false \
    "SELECT COUNT(DISTINCT session_id) AS sessions, COUNT(*) AS events, MIN(timestamp) AS earliest_event, MAX(timestamp) AS latest_event FROM \`$PROJECT_ID.$DATASET.agent_events\`"
デフォルトの 5 セッション実行の場合、数分間にわたる 5 セッションと 30 イベントが表示されます。(以下の現実的なシナリオをシードすると、同じクエリで約 3 日間にわたって約 100 セッションがレポートされます)。
イベントが着地したことを確認します。
bq query --use_legacy_sql=false \
    "SELECT event_type, COUNT(*) AS n FROM \`$PROJECT_ID.$DATASET.agent_events\` GROUP BY event_type ORDER BY n DESC"
TOOL_COMPLETED 行が 25 行、AGENT_COMPLETED 行が 5 行表示されます(各セッションで submit_request が 1 つ、evaluate_option が 3 つ、commit_outcome が 1 つ、終了 AGENT_COMPLETED が 1 つ(セッションごとに 5 つのツールイベントと 1 つのエージェント終端子)が生成されます)。AGENT_COMPLETED 行は、端末イベント検出のために bqaa context-graph がキーとするセッション終端です。
省略可: 実際の規模のデータ
上記の 5 セッションのコーパスは、最初の実行を高速かつ安価にするために意図的に小さくしています。本番環境のデータ(複数のエージェントとユーザーが数日間にわたって分散し、失敗したセッション、孤立したセッション、切り捨てられたセッションがある)が必要な場合は、decision-realistic シナリオを使用します。デフォルトでは 72 時間のウィンドウで 100 セッションになります。上記の初回実行パスは変更されていません。
bqaa seed-events \
    --project-id "$PROJECT_ID" \
    --dataset-id "$DATASET" \
    --scenario decision-realistic \
    --sessions 100 \
    --seed 42
JSON レポートの session_outcome_counts には、おおよそ {"success": 70, "failed": 10, "orphaned": 10, "truncated": 10} のミックスが表示されます。
行から各セッションを分類して結果の分布を確認します(孤立 = AGENT_COMPLETED なし、失敗 = status = 'error' ありの AGENT_COMPLETED、切り捨て = is_truncated = true ありの行、それ以外は成功)。1 回目のパスで各セッションを分類し、2 回目のパスで結果ごとに集計します。
bq query --use_legacy_sql=false \
    "WITH per_session AS (SELECT session_id, CASE WHEN COUNTIF(event_type = 'AGENT_COMPLETED') = 0 THEN 'orphaned' WHEN COUNTIF(event_type = 'AGENT_COMPLETED' AND status = 'error') > 0 THEN 'failed' WHEN COUNTIF(is_truncated) > 0 THEN 'truncated' ELSE 'success' END AS outcome FROM \`$PROJECT_ID.$DATASET.agent_events\` GROUP BY session_id) SELECT outcome, COUNT(*) AS sessions FROM per_session GROUP BY outcome ORDER BY outcome"
成功が約 70 件、失敗が 10 件、孤立が 10 件、切り捨てが 10 件(同じデータセットで以前にシードした場合は、初回実行コーパスの成功セッションが 5 件)が表示されます。
孤立した 10 個のセッションは AGENT_COMPLETED を出力しなかったため、デフォルトの bqaa context-graph 実行ではスキップされます(終了イベントが閉じられたセッションのみが具体化されます)。永続的に再試行するのではなく、session_orphaned として表示するには、実行時に --max-session-age-hours を追加します。本番環境に移行するの --max-session-age-hours をご覧ください。
7. コンテキスト グラフを具体化する
bqaa context-graph は未加工の agent_events を読み取り、デプロイされたグラフから抽出する内容を直接導出します。つまり、プロパティ グラフ スキーマを適用するで適用した CREATE PROPERTY GRAPH 定義を BigQuery の INFORMATION_SCHEMA.PROPERTY_GRAPHS から読み取り、参照するテーブルのスキーマと結合し、エンティティ、リレーションシップ、列の型を算出して、グラフテーブルに入力します。--graph agent_decisions_graph を使用して、デプロイされたグラフを名前で指定します。渡す SQL ファイルはありません。
実行
bqaa context-graph ローカル:
bqaa context-graph \
    --project-id "$PROJECT_ID" \
    --dataset-id "$DATASET" \
    --graph agent_decisions_graph \
    --lookback-hours 24 \
    --format json
構造化された JSON レポートが表示されます。
{
  "run_id": "...",
  "sessions_discovered": 5,
  "sessions_materialized": 5,
  "sessions_failed": 0,
  "rows_materialized": {
    "DecisionRequest": 5,
    "DecisionOption": 15,
    "DecisionOutcome": 5
  },
  "ok": true
}
ok: true は、bqaa context-graph が 5 つの完了したセッションを見つけ、AI.GENERATE を介して各セッションから意思決定フローを抽出し、対応する行をグラフ テーブルに書き込んだことを示します。決定論的抽出(--extraction-mode=compiled-only、後述)は、同じレポートの形状(同じフィールド、同じ ok: true)を返します。AI.GENERATE 呼び出しをスキップするだけです。
トラブルシューティング: 抽出が空になる
error_code = "empty_extraction" を含む ok: false が表示される場合、最も一般的な原因は、aiplatform.googleapis.com API がまだ伝播されていないか、アカウントに roles/aiplatform.user がないことです。1 分待ってから再試行するか、ロールを付与します。
USER_EMAIL=$(gcloud auth list --filter=status:ACTIVE --format="value(account)")
gcloud projects add-iam-policy-binding "$PROJECT_ID" \
    --member="user:$USER_EMAIL" --role="roles/aiplatform.user"
その後、上記の bqaa context-graph コマンドを再実行します。
グラフに行があることを確認します。
bq query --use_legacy_sql=false \
    "SELECT COUNT(*) AS n FROM \`$PROJECT_ID.$DATASET.decision_request\`"
5 行が表示されます。5 つのセッション全体で、合計 25 個のグラフノード(5 個の DecisionRequest、15 個の DecisionOption、5 個の DecisionOutcome)が、15 個の evaluatesOption エッジと 5 個の resultedIn エッジで結合されています(セッションごとに 1 つの決定ウェブ)。
イベントから意思決定を抽出する 2 つの方法
bqaa context-graph には 2 つの抽出パスがあります。ワークロードに一致するものを選択します。
- デフォルトの抽出。最も簡単な方法。BigQuery の
AI.GENERATEを使用してイベント コンテンツを読み取り、エンティティと関係を推論します。追加のコードなしで、あらゆるイベント シェイプに対して動作します。この Codelab ではこれを使用します。 - 確定的抽出(
--extraction-mode=compiled-only)。低コストで監査に適したパス。ドメイン用に 1 回作成する小さな Python 参照抽出ツールを使用します。Vertex AI の呼び出しなし、トークンごとの料金なし、完全に再現可能な出力。本番環境のデプロイでは、コストの予測可能性や厳密な再現性が重要な場合に、これを選択します。
コンテキスト グラフのデプロイガイドは、IAM の詳細やリファレンス抽出子の作成方法など、両方のパスのリファレンスです。
8. 決定トレースをクエリする
グラフが入力されたら、監査の質問に直接回答できます。具体的な例として、「各リクエストについて、エージェントはどのような選択肢を検討し、どのように解決したか?」を考えてみましょう。GQL では、リクエスト、オプション、結果をまたぐ単一のトラバーサルです。
クエリをファイルに書き込みます(traversal.sql)。${DATASET} マーカーは、次の手順で実行するときに挿入されます。
cat > traversal.sql <<'SQL'
SELECT *
FROM GRAPH_TABLE (
  ${DATASET}.agent_decisions_graph
  MATCH
    (req:DecisionRequest) -[eo:evaluatesOption]-> (opt:DecisionOption),
    (req)                 -[ri:resultedIn]->      (out:DecisionOutcome)
  COLUMNS (
    req.request_id   AS request,
    req.request_text AS question,
    opt.option_label AS considered,
    opt.confidence   AS score,
    out.status       AS outcome,
    out.rationale    AS rationale
  )
);
SQL
実行する:
envsubst < traversal.sql | bq query --use_legacy_sql=false --max_rows=20
15 行(リクエストごとに 3 つのオプション、5 つのリクエスト)が表示されます。各行には、リクエスト、エージェントが検討したオプション、信頼スコア、最終結果、根拠が表示されます。
1 つの意思決定の全体像を把握するには、request_id でフィルタして、監査チームが必要とする行セット(入力された質問、重み付けされたオプション(スコア付き)、コミットされた根拠)を取得します。
BigQuery Studio でグラフを可視化する
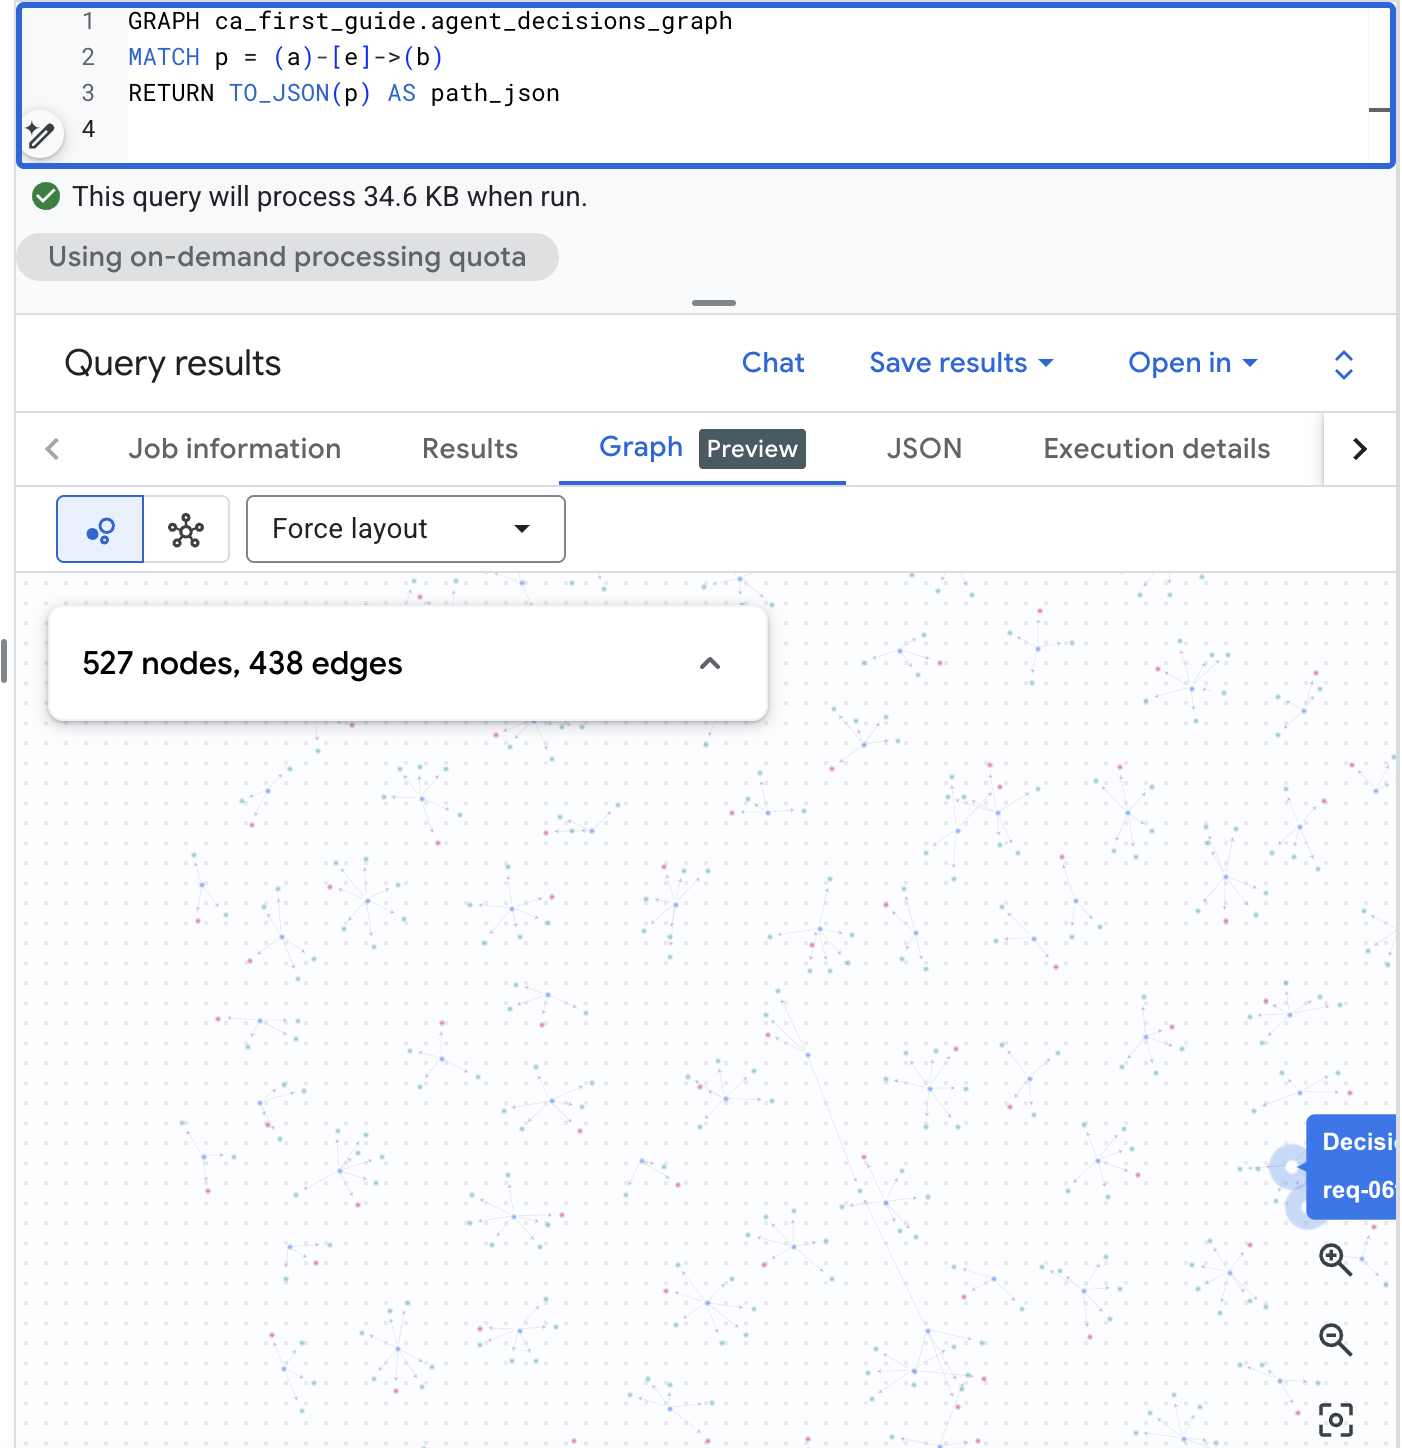
BigQuery Studio では、グラフを視覚的にレンダリングすることもできます。BigQuery コンソールで BigQuery Studio を開き、次のパスクエリを実行してから、結果ペインを [グラフ] タブに切り替えて、決定ウェブを表示します。現実的な規模のコーパスを使用すると、リクエスト、オプション、結果の視覚的なマップが表示されます。
GRAPH agent_analytics_demo.agent_decisions_graph
MATCH p = (a)-[e]->(b)
RETURN TO_JSON(p) AS path_json
同じ質問を平易な英語で尋ねる
すべての監査閲覧者が GQL を記述するわけではありません。BigQuery 会話型分析(プレビュー版)を使用すると、コンプライアンス チームは同じ種類の質問を自然言語で尋ねて、構造化された回答カードを受け取ることができます。クエリ構文や結合を学習する必要はありません。
agent_decisions_graph(agent_events と決定テーブルも含む)を会話分析のデータソースとして登録し、監査の質問を直接行います。
監査の質問(平易な英語): 「コミットされた結果に到達しなかったリクエストはどれですか?」
会話分析はグラフを分析し、SQL を記述して、サポート テーブルとともに平易な英語で回答します。ここでは、記録されたすべてのリクエストがコミットされた結果に達したことを示しています。

上記の回答は、オプションの現実的な規模のデータステップ(90 件のマテリアライズされたリクエスト、すべてコミット済み)の現実的な規模のコーパスを反映しています。正確な数値は、シードしたコーパスによって異なります。デフォルトの 5 セッション実行では 5 が表示されます。
設定については、会話分析のドキュメントをご覧ください。
9. 本番環境に移行する
上記のローカル実行ではデフォルトの動作が使用されます。これは、実際のデプロイの基本をすでにカバーしています。すべての実行で監査証跡(構造化された Cloud Logging と、データセットの状態テーブルの実行ごとの行)が残され、一時的な障害は自動的に再試行され、完全に成功したセッションでのみ進行するため、二重カウントはありません。
プロダクション制御(決定論的抽出(--extraction-mode=compiled-only)、セッションの停止検出(--max-session-age-hours)、過去のウィンドウの 1 回限りの再生(--backfill --from / --to、通常の更新とは別に追跡されるため、ライブ スケジュールを妨げることはありません)、実行ごとのバッチ境界(--max-sessions))は、必要に応じて使用するオプトイン フラグです。コンテキスト グラフのデプロイガイドでは、完全な IAM マトリックスと推奨スケジュールを使用して、それぞれを文書化しています。
10. クリーンアップ
作成したものを削除して、アイドル状態のデータセットに対して課金されないようにします。
bq rm -r -f --dataset "$PROJECT_ID:$DATASET"
この単一のコマンドで、データセット、エージェント イベント、グラフテーブル、状態テーブルがまとめて削除されます。
11. 完了
おめでとうございます!外部のグラフ データベースや ETL パイプラインを使用せずに、エージェントの生イベントログをクエリ可能なエージェント コンテキスト グラフに変換し、単一の決定をエンドツーエンドでトレースしました。
エージェントが重要な意思決定を行う場所(信用引受、事前承認、マーケティング予算の移動、調達、カスタマー サービス、社内 IT など)では、同じパターンが適用されます。独自のエージェント コンテキスト グラフを構築するには、出発点として Codelab アーティファクトをコピーし、2 つの宣言型ファイル(テーブル DDL と CREATE PROPERTY GRAPH スキーマ)をドメインに合わせて調整して BigQuery に適用します。bqaa context-graph --graph は、デプロイされたグラフを INFORMATION_SCHEMA から読み取り、残りを導出します。
学習した内容
- BigQuery データセットを作成し、エージェントの意思決定ドメインを記述するプロパティ グラフ スキーマを適用する方法。
- 合成イベント コーパスを使用して
agent_eventsを入力する方法。 bqaa context-graphを実行して、これらのイベントからエージェントの意思決定トレースをエージェント コンテキスト グラフに抽出し、INFORMATION_SCHEMAからグラフ定義を読み取る方法。- GQL で結果のグラフをクエリして、監査スタイルの回答を読み取る方法。
リファレンス ドキュメント
- BigQuery Agent アナリティクス SDK リポジトリ
- Codelab のアーティファクトと適応ガイド
- コンテキスト グラフのデプロイガイド: 必要な API、IAM マトリックス、推奨スケジュール、Cloud Monitoring アラート クエリ、Terraform モジュール。
- BigQuery Graph のドキュメント(プレビュー)。
- BigQuery 会話型分析のドキュメント(プレビュー)。